Texto a video con IA: escribe la escena y obtén el video
La IA de texto a video convierte una escena escrita en un clip corto. Describe quién aparece, dónde está y qué pasa, y elige uno de 10 modelos. Recibes un MP4 con sonido de 3 a 30 segundos, casi siempre en uno a cinco minutos. No necesitas cámara ni saber editar.
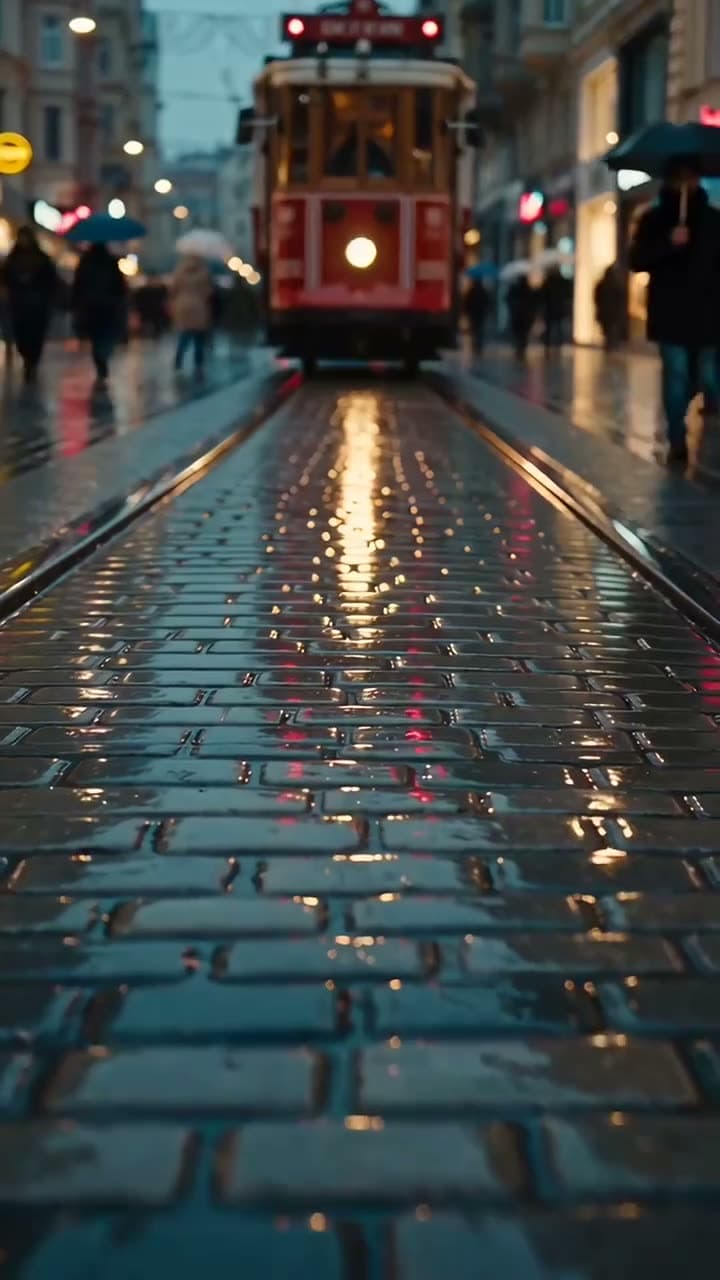
Resultados reales
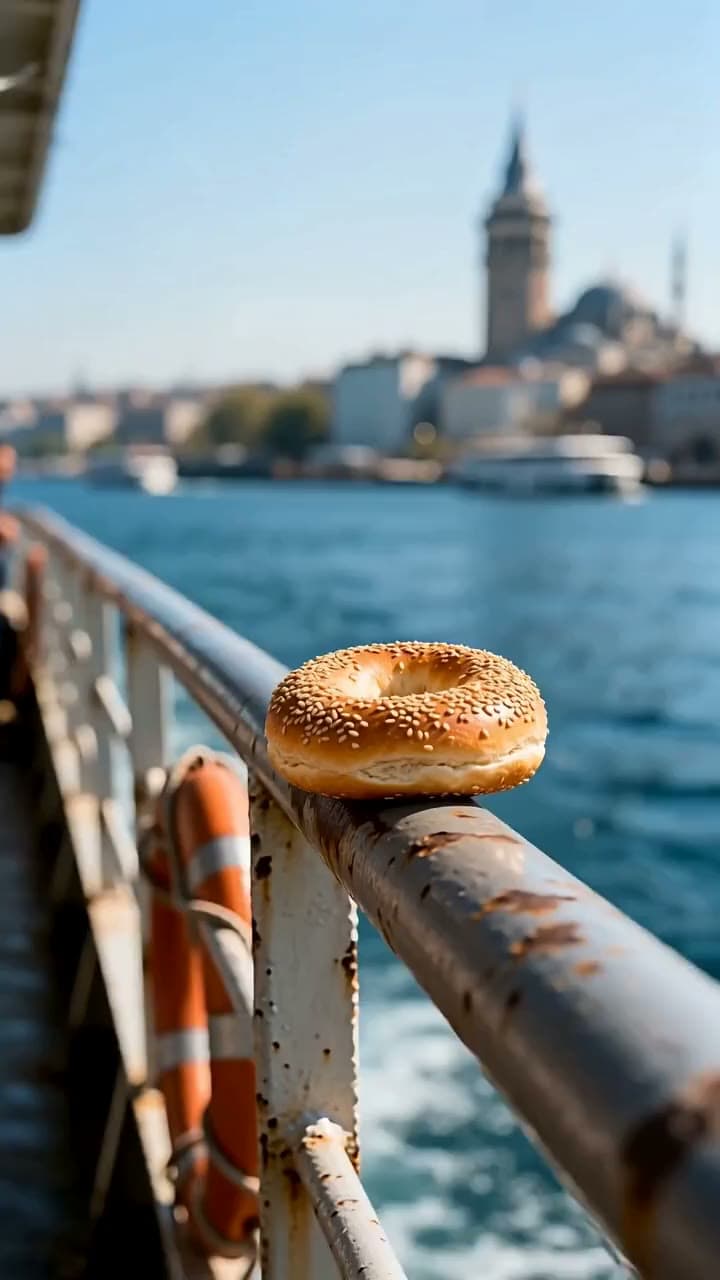
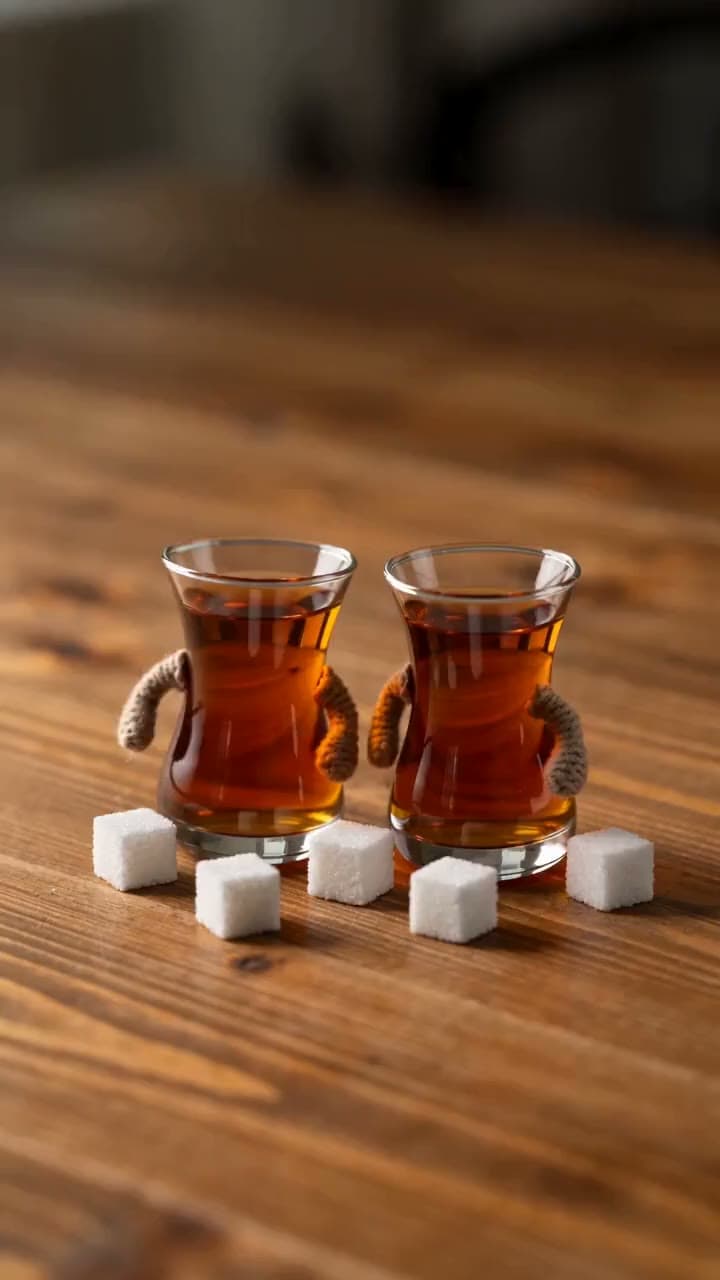
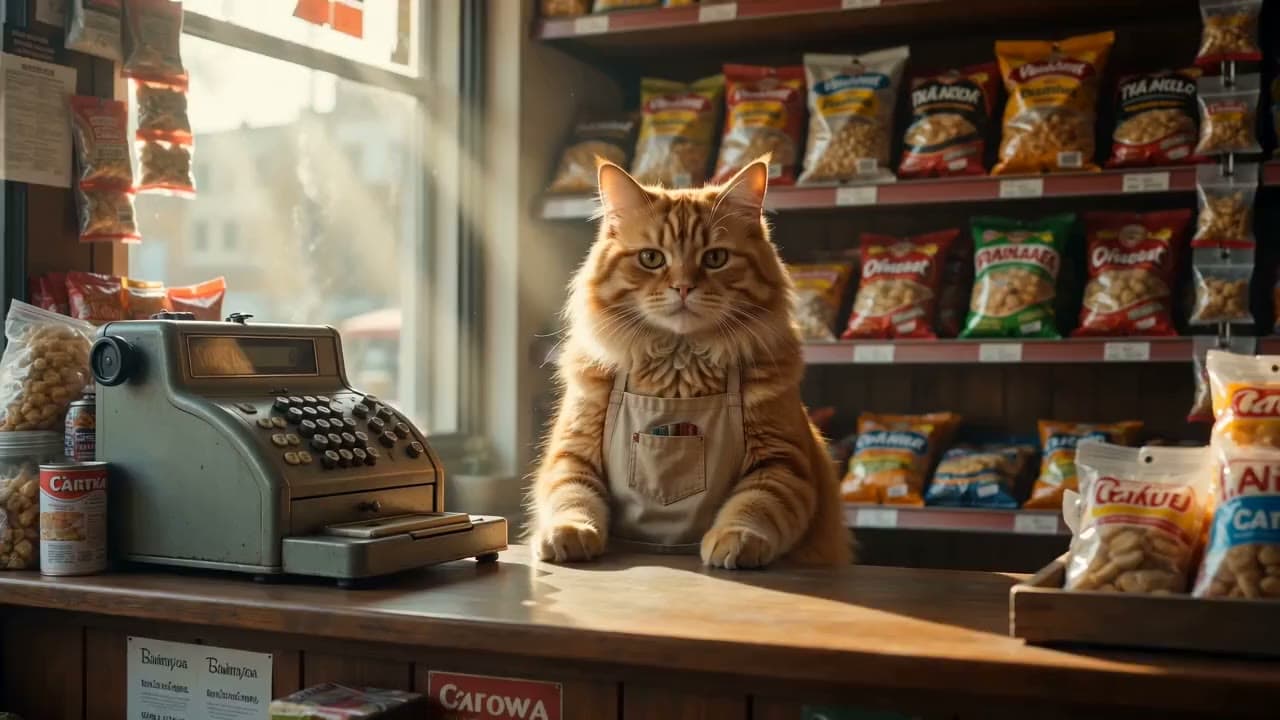
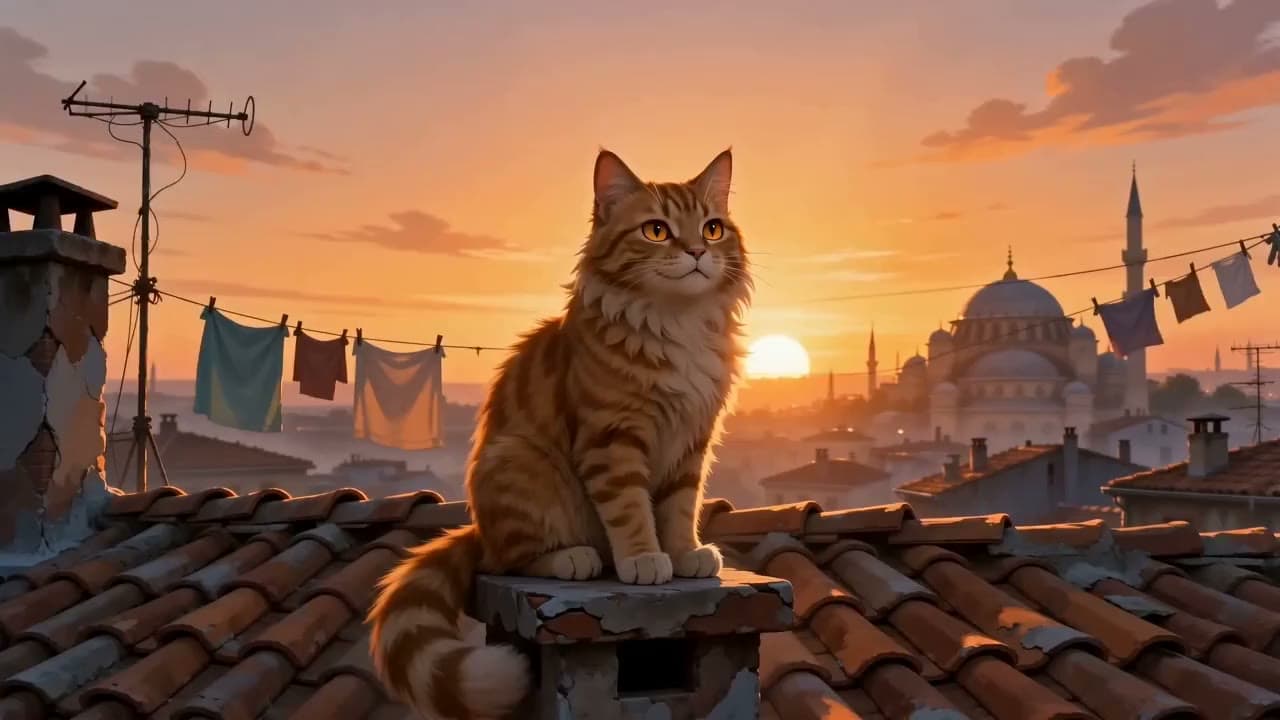
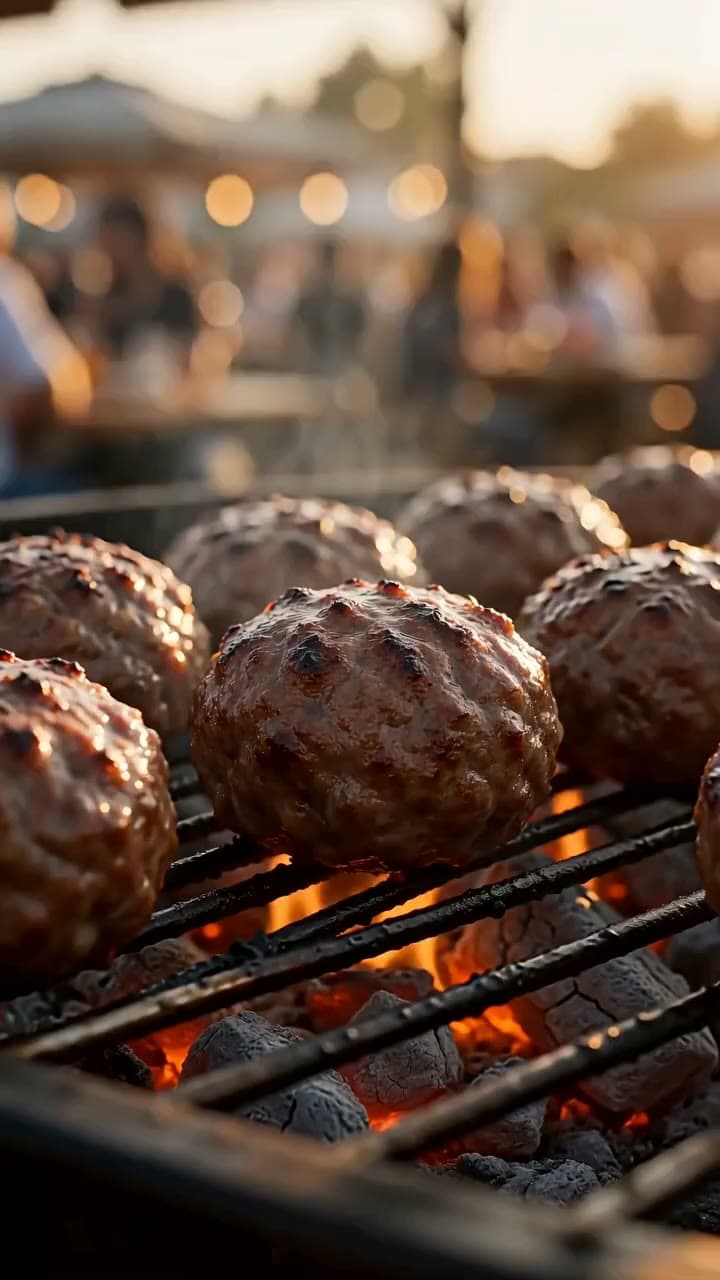
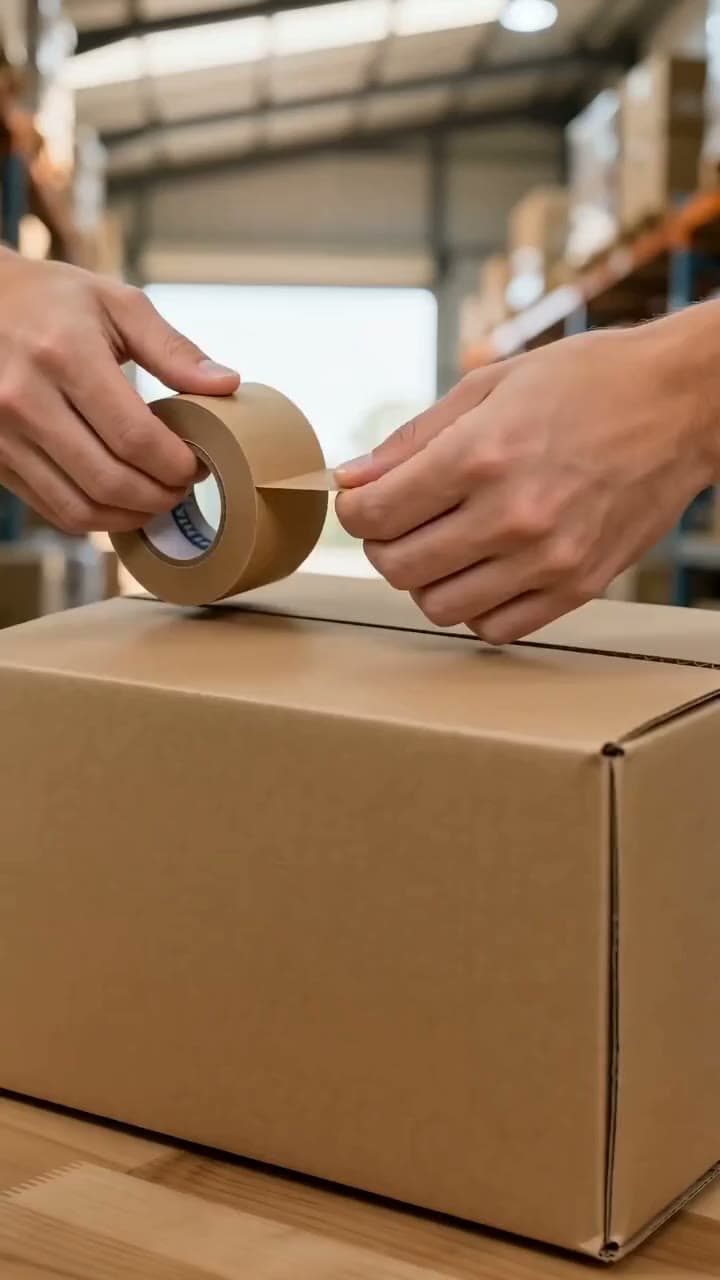
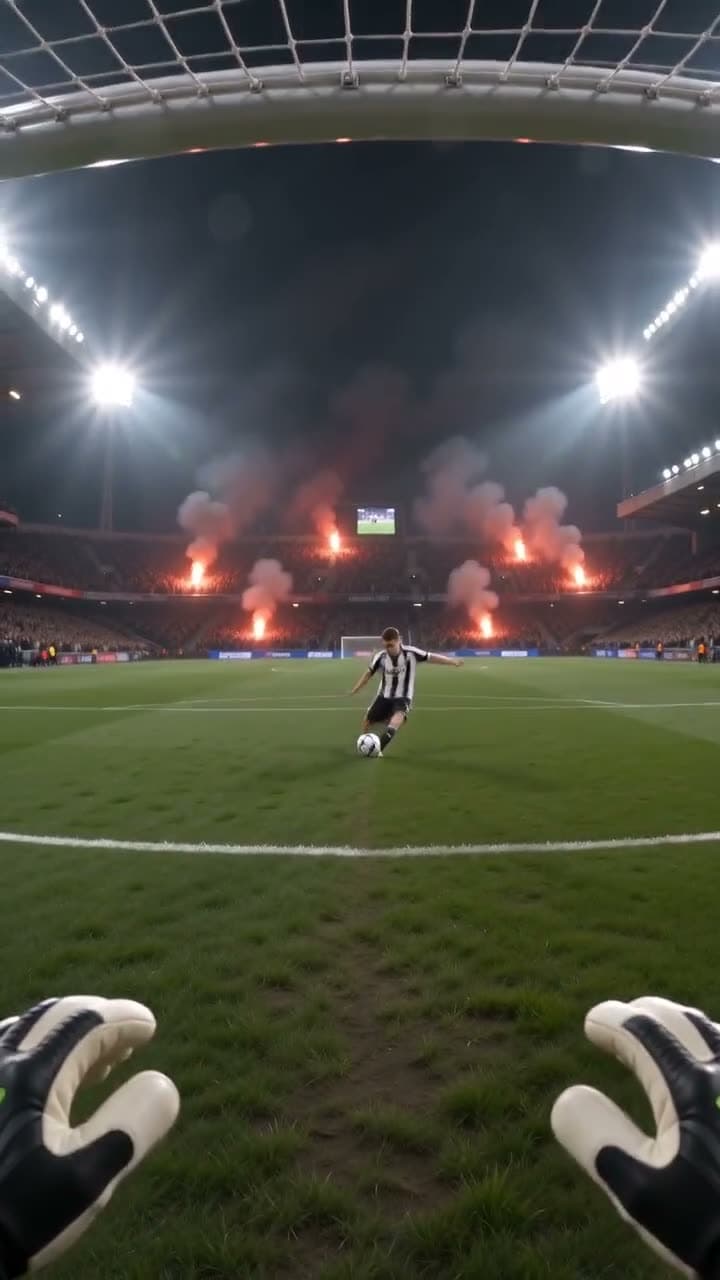
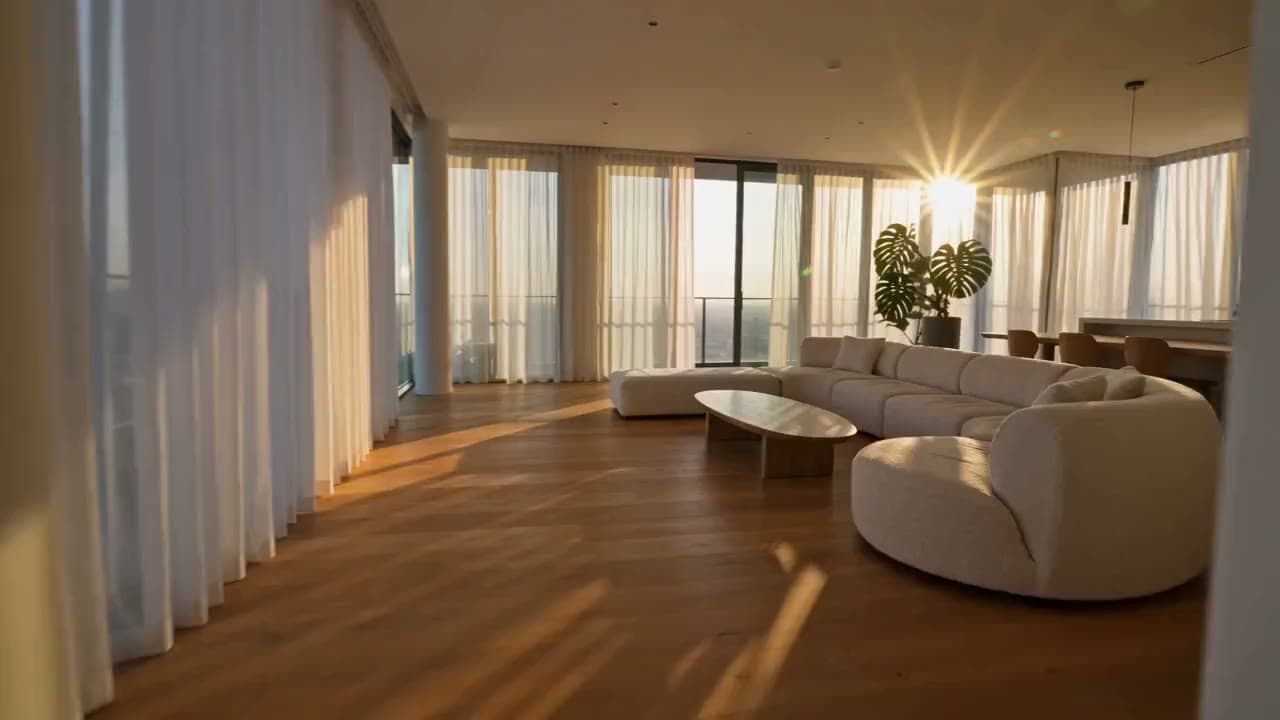
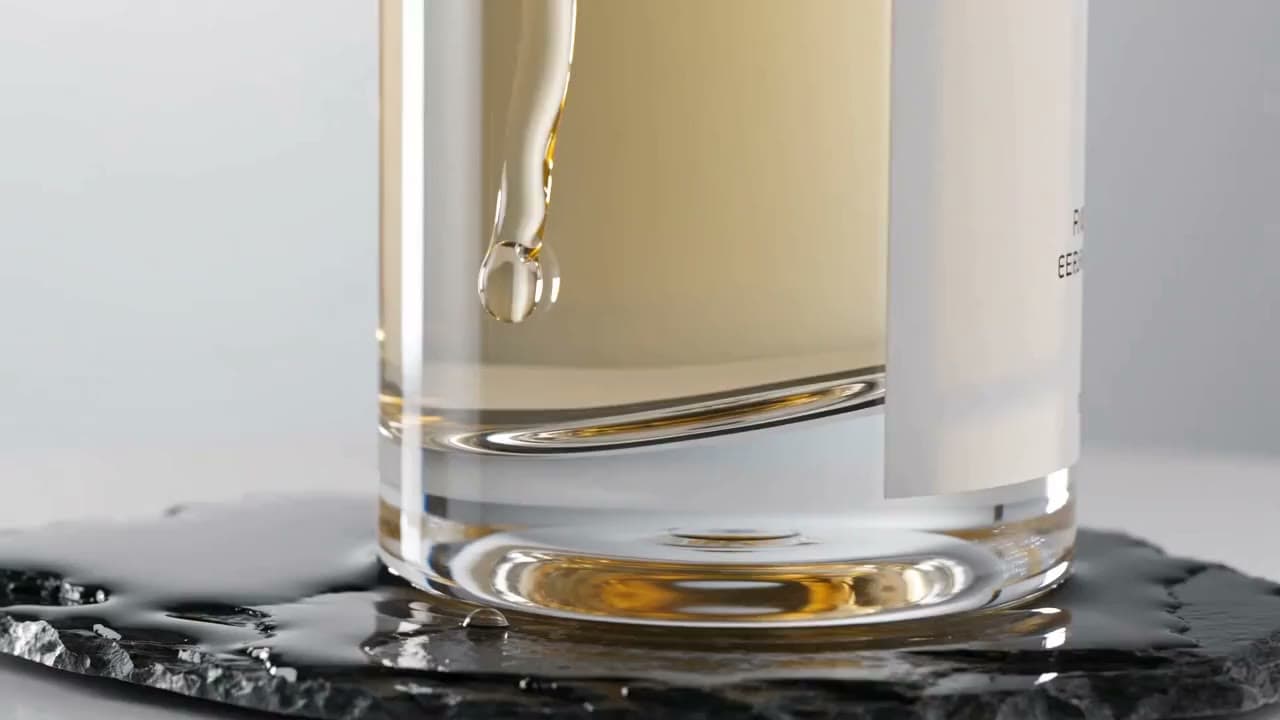
Hecho con esta herramienta
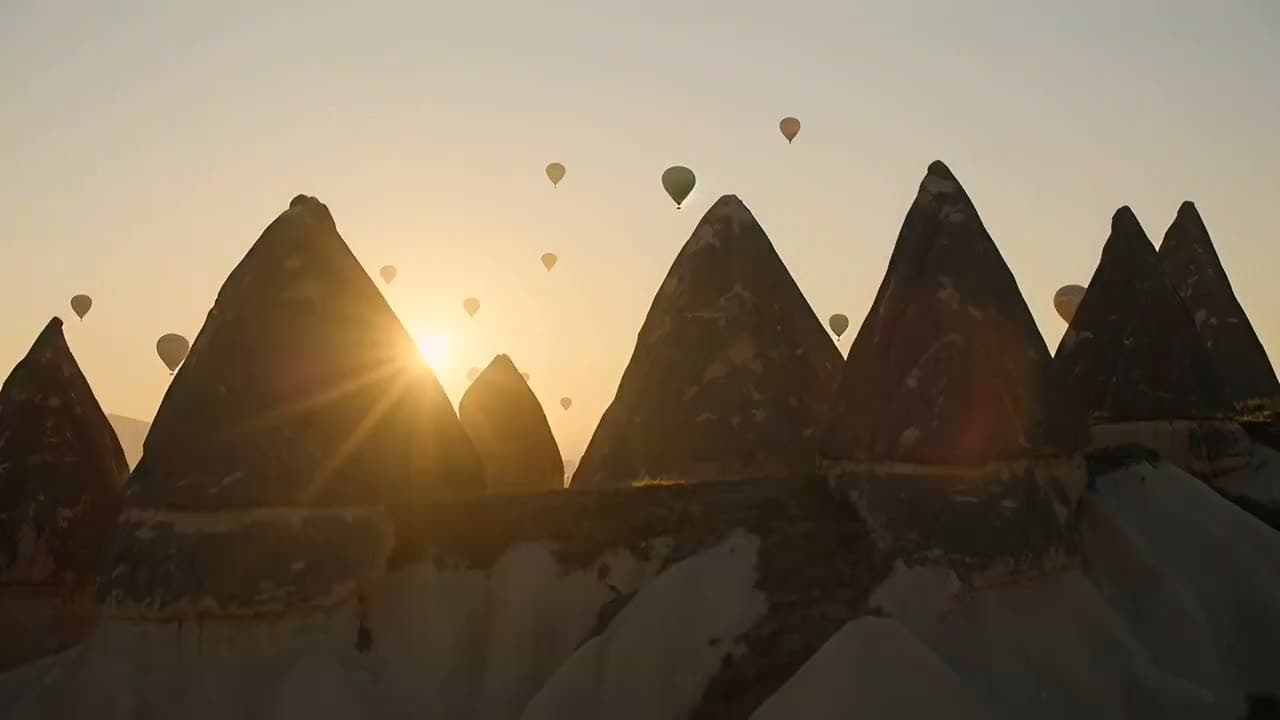
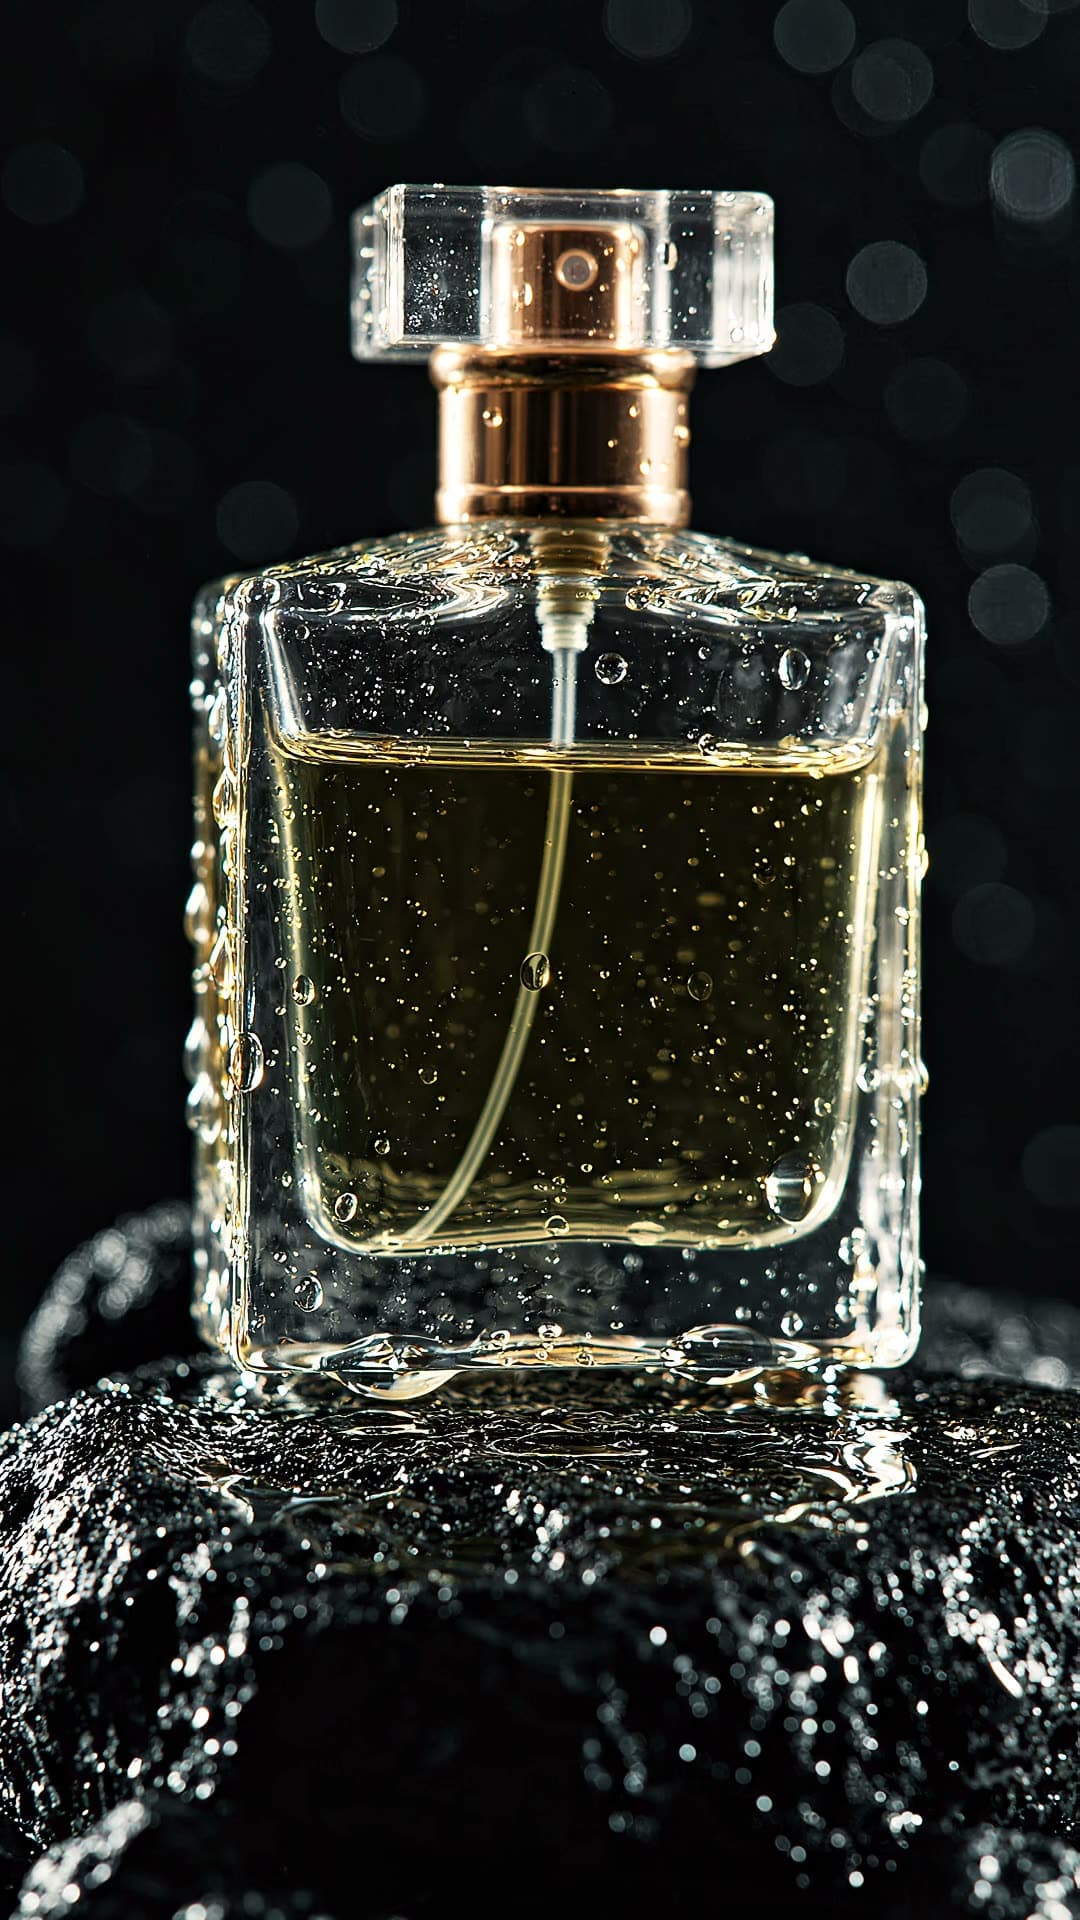
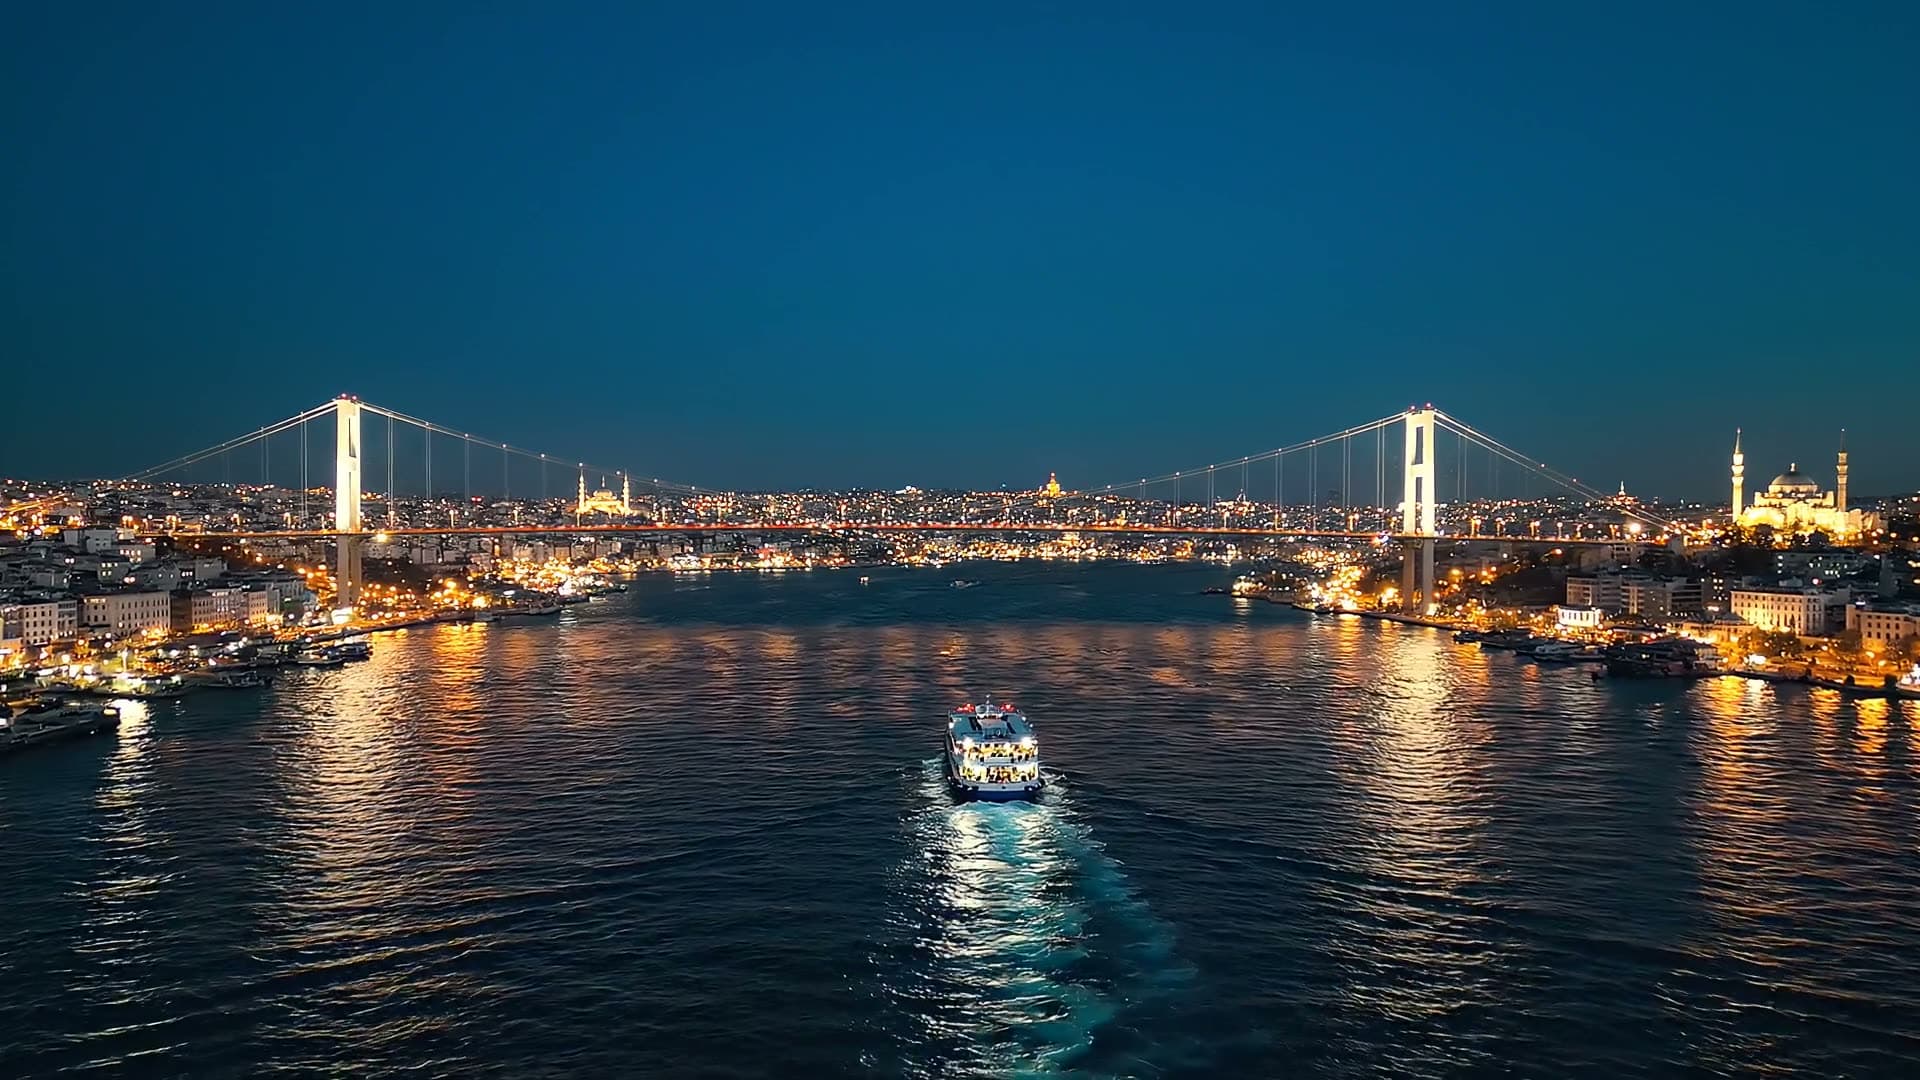
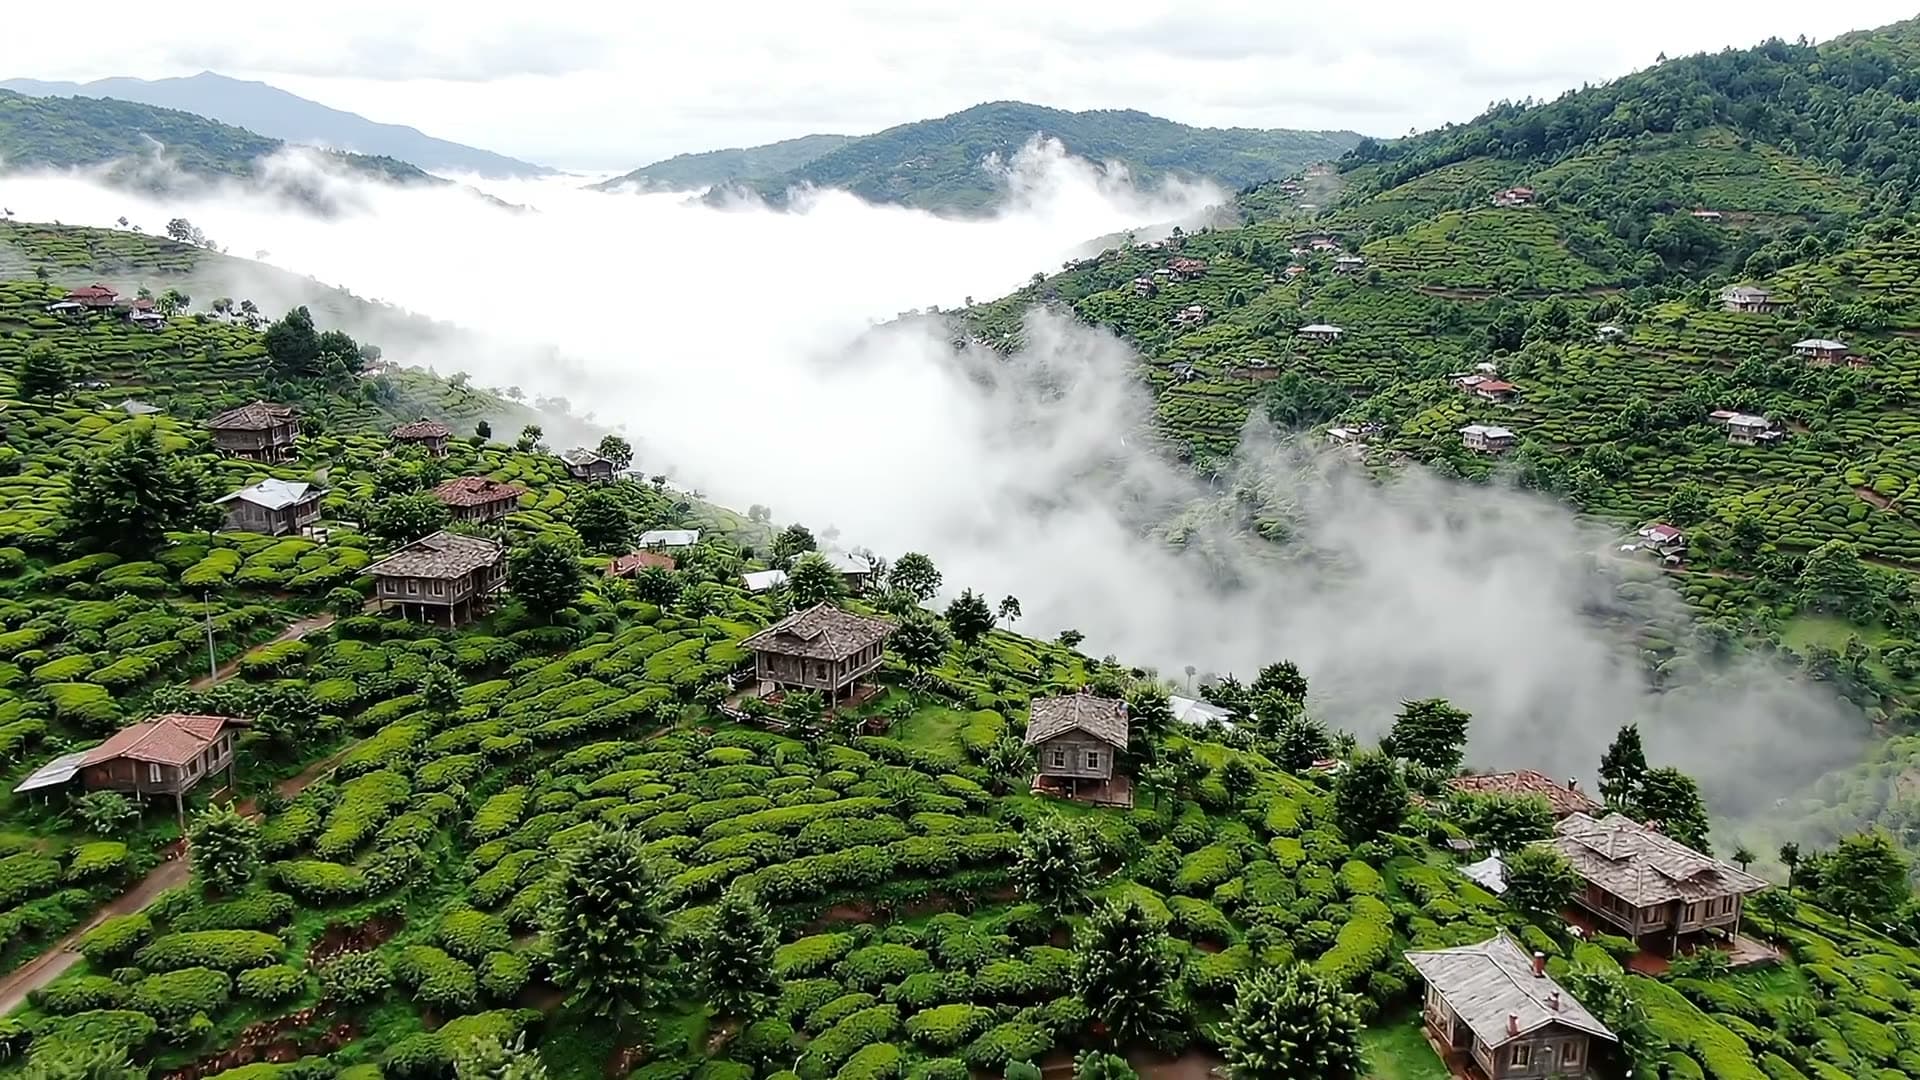
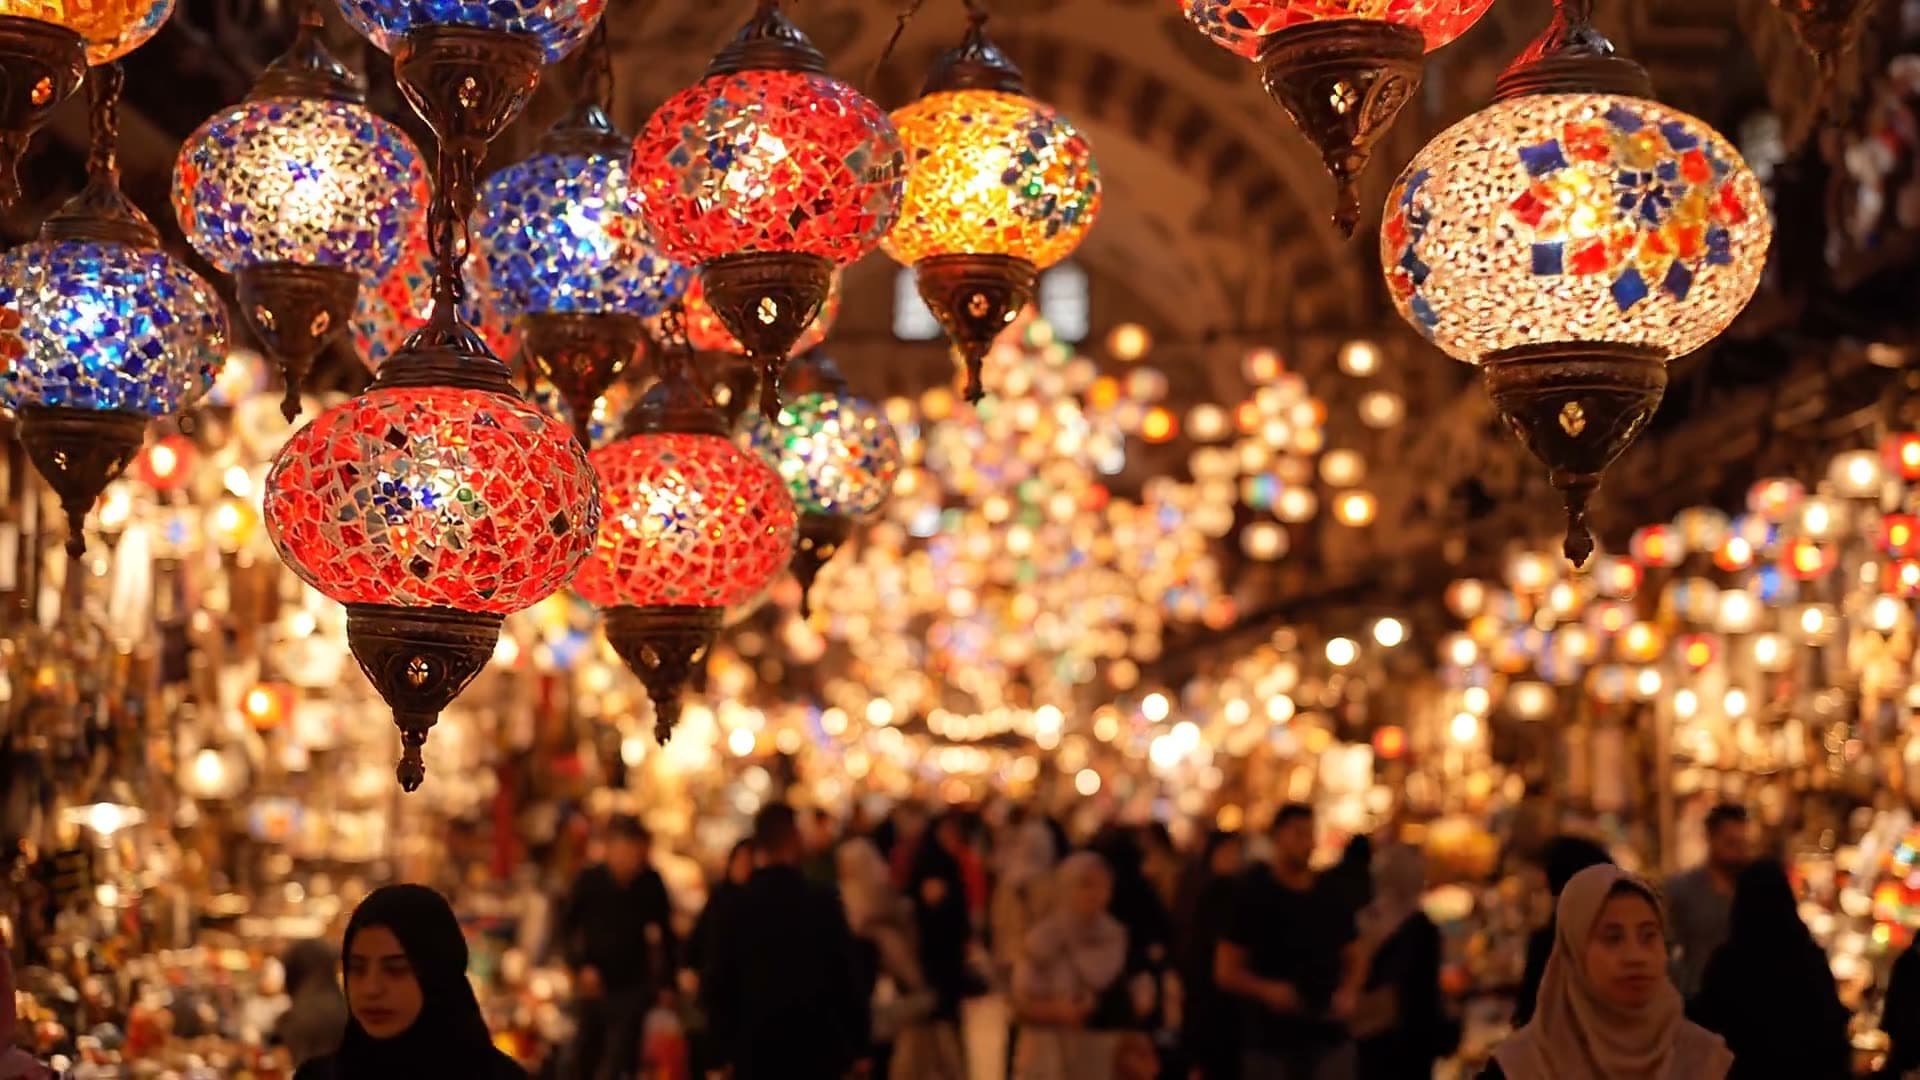
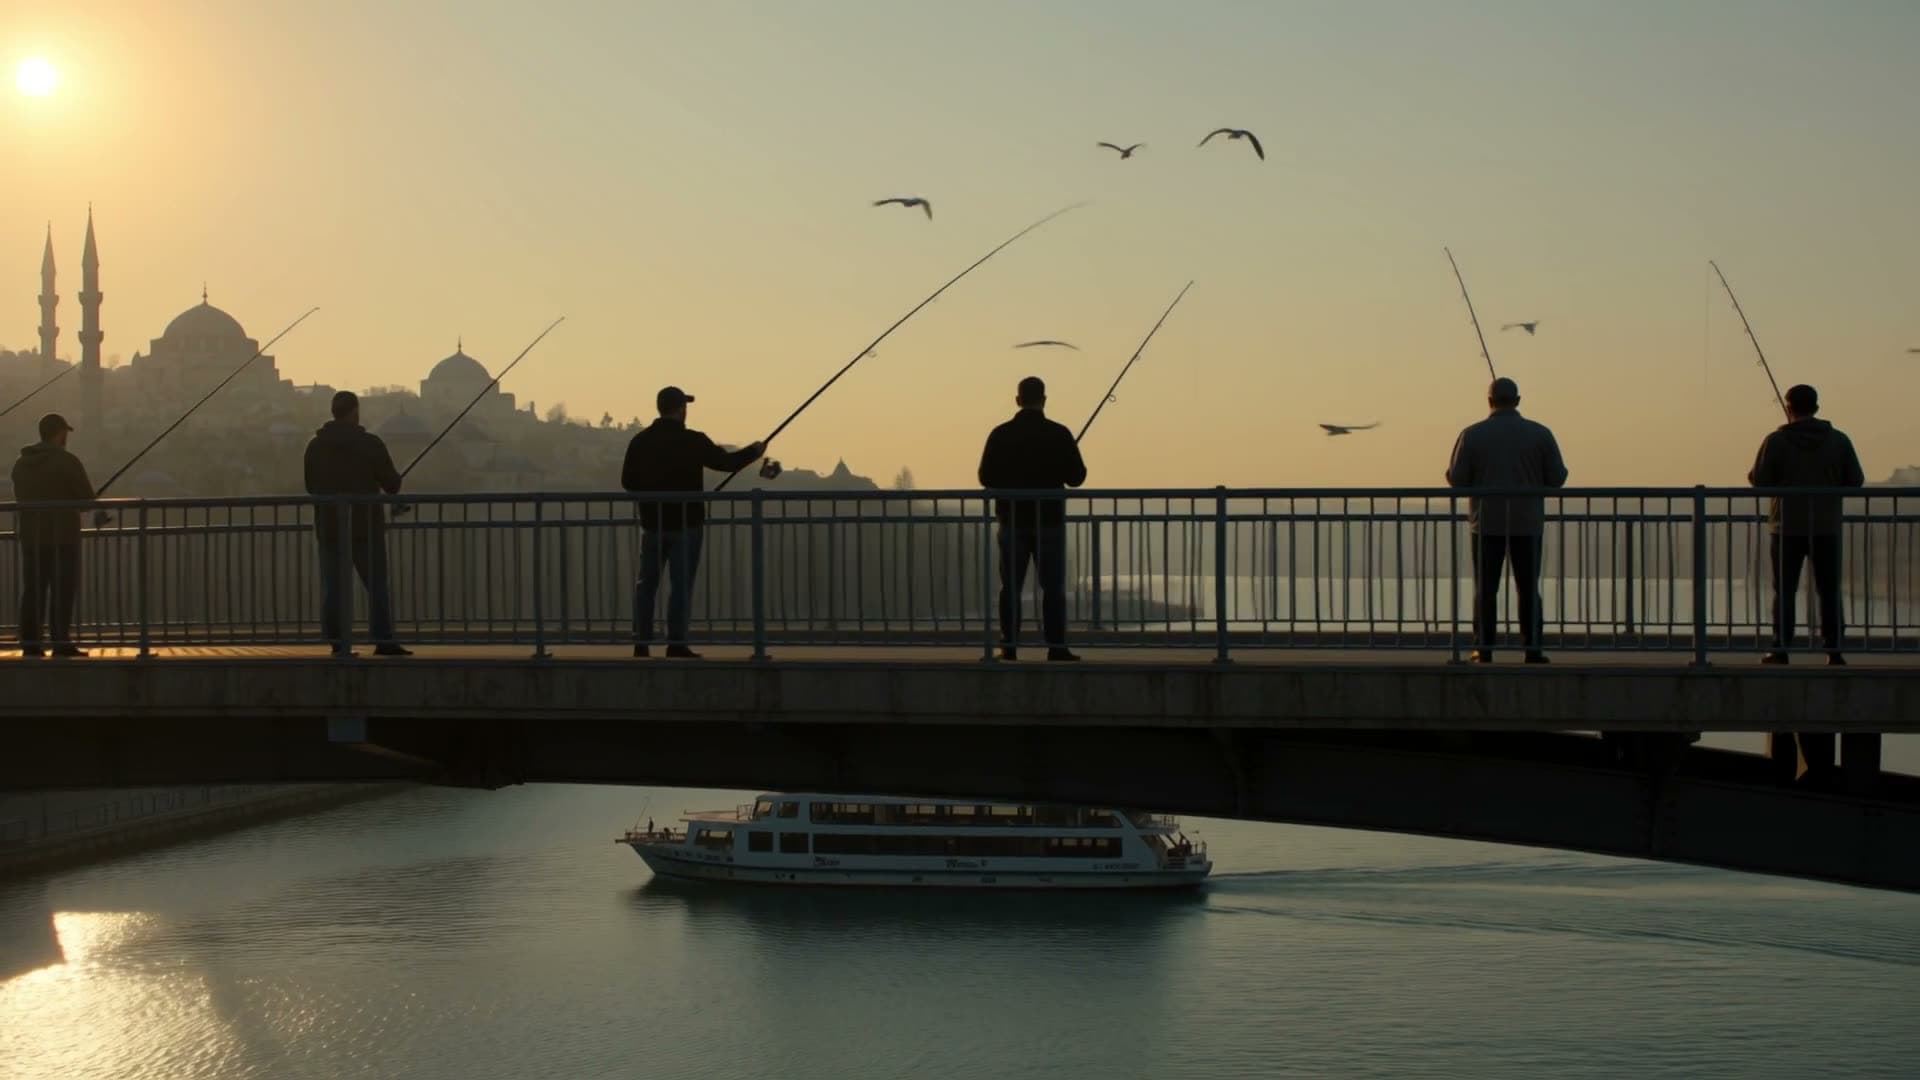
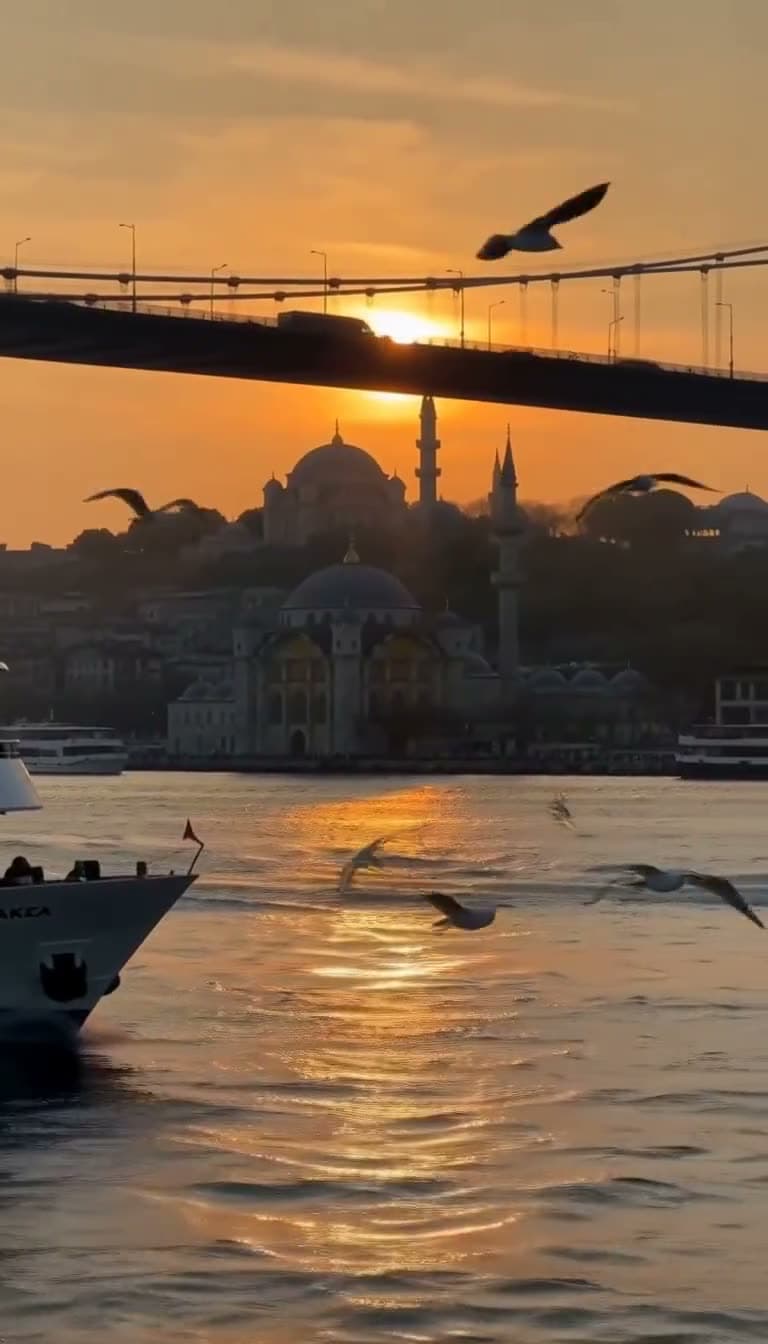
Cada ejemplo indica el modelo que lo creó. Toca un video para abrirlo con sonido.
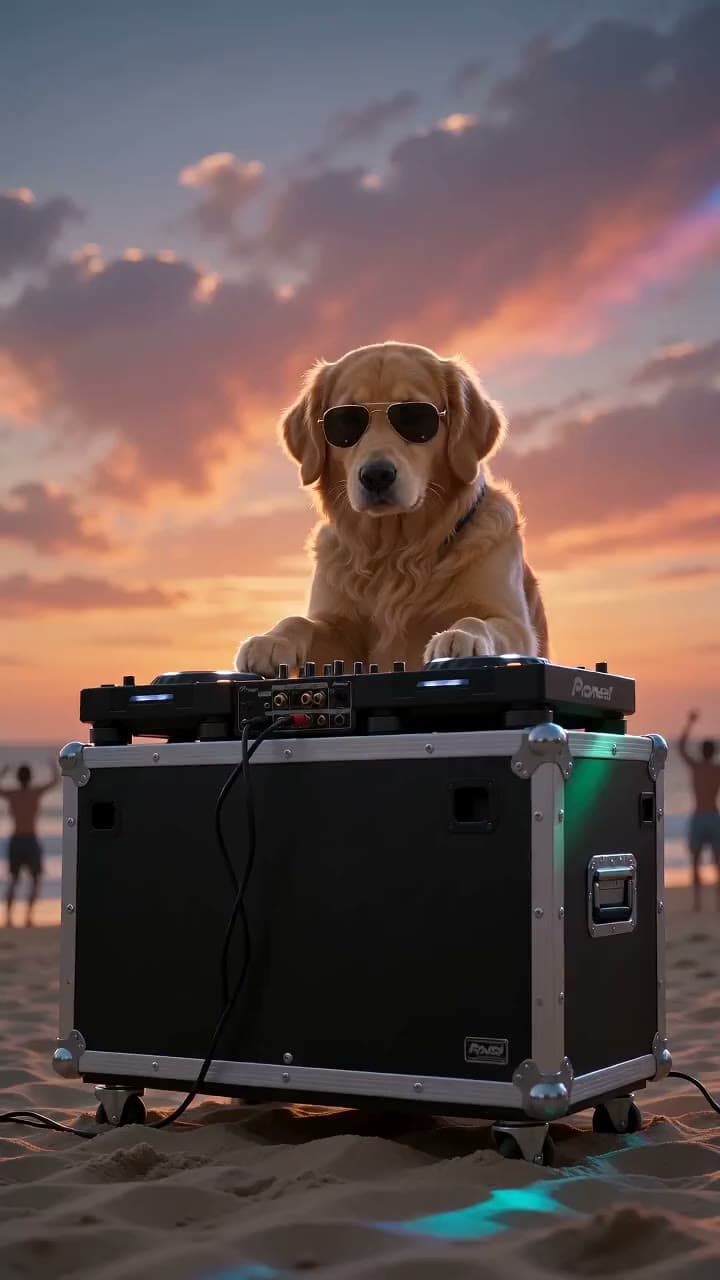
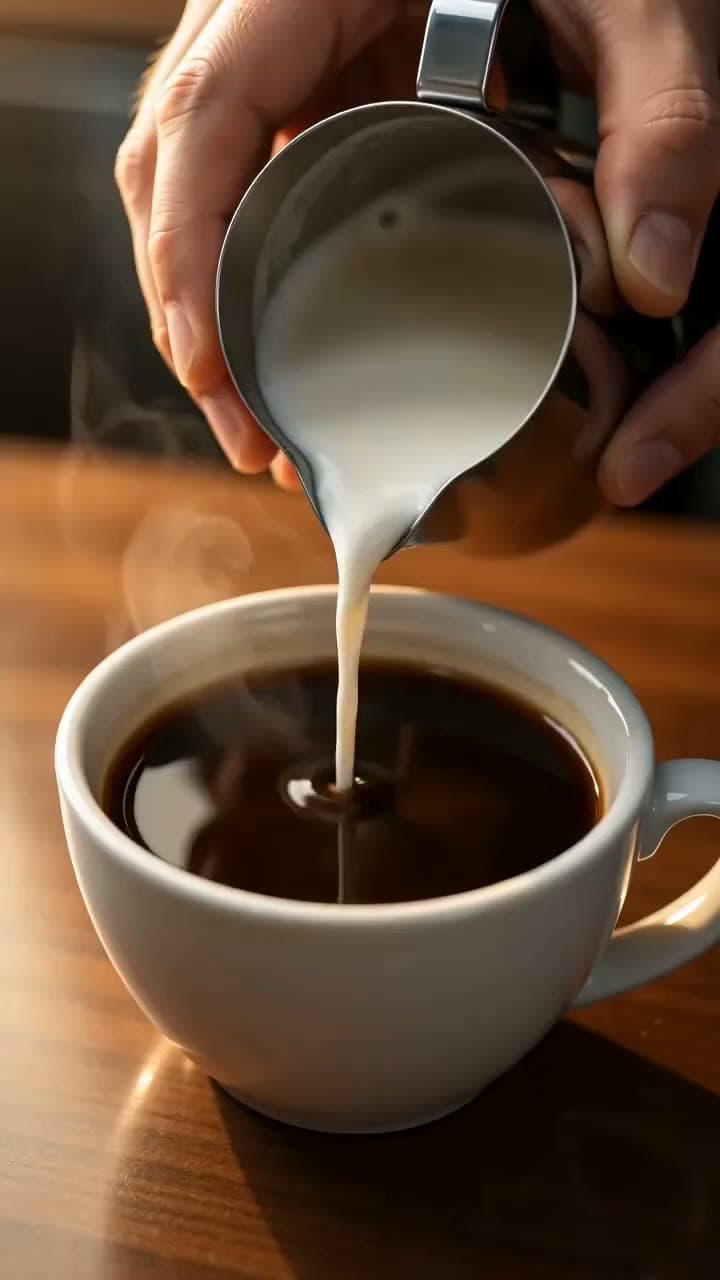
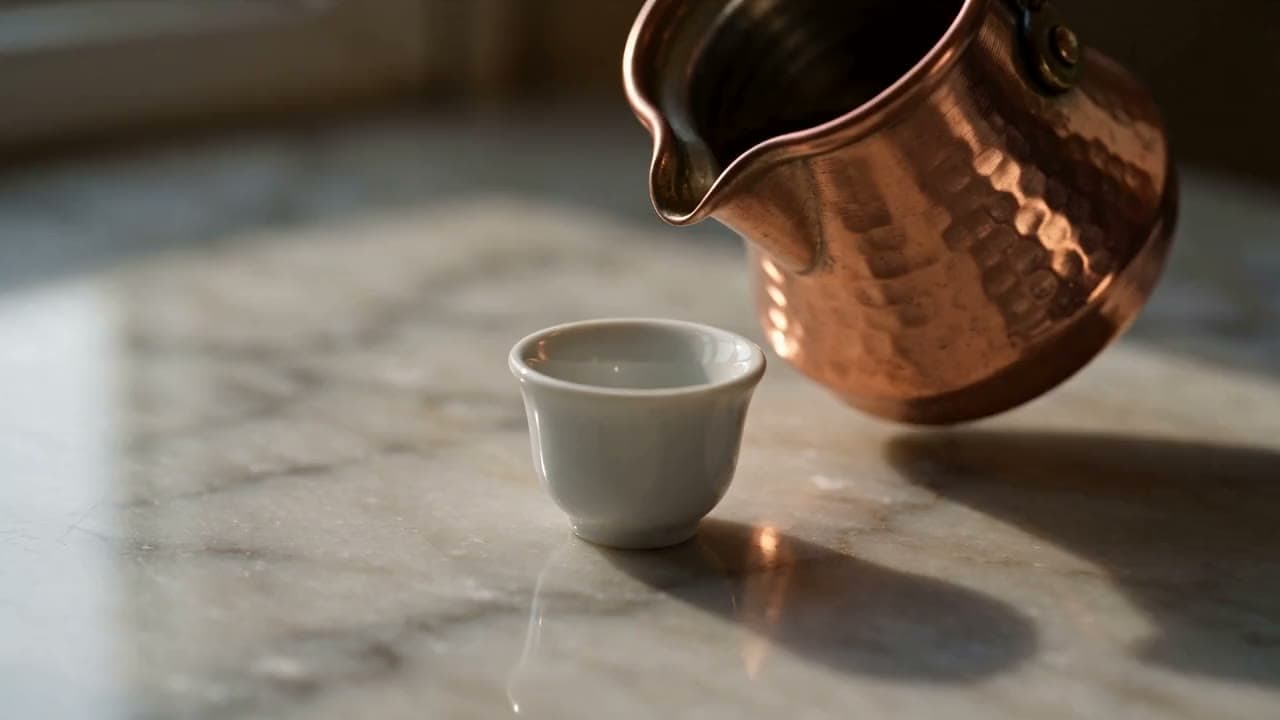
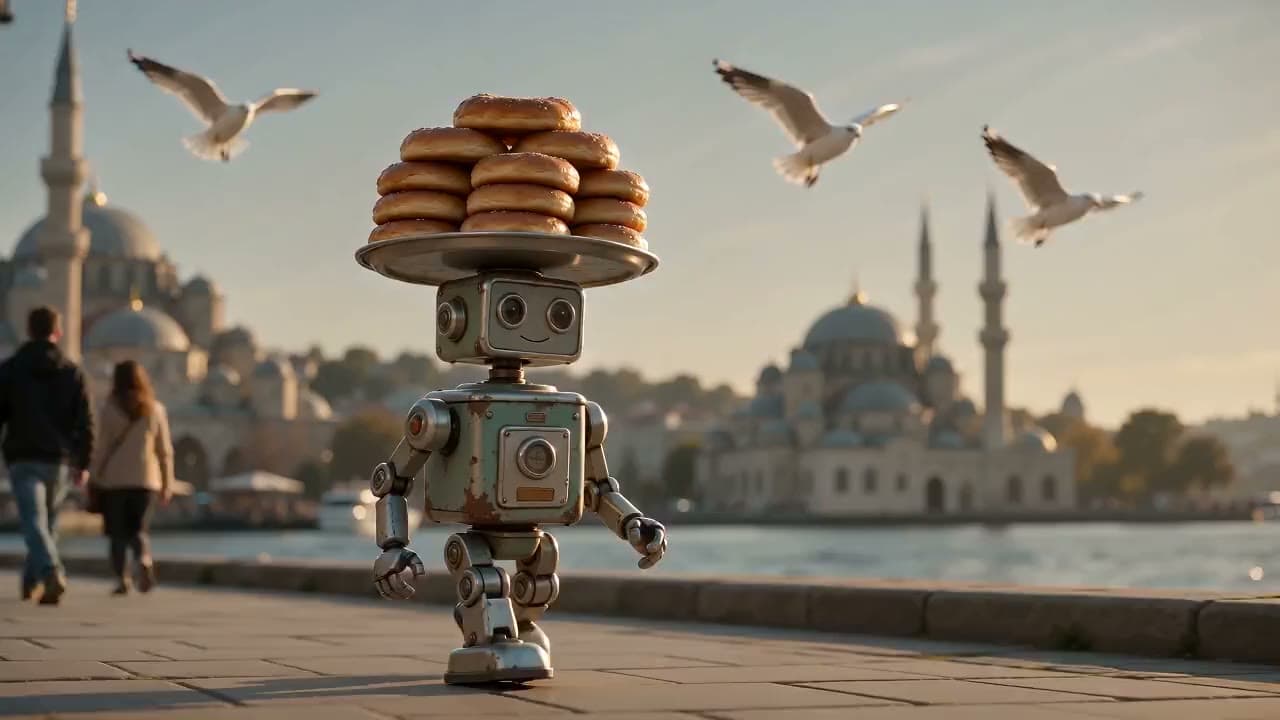
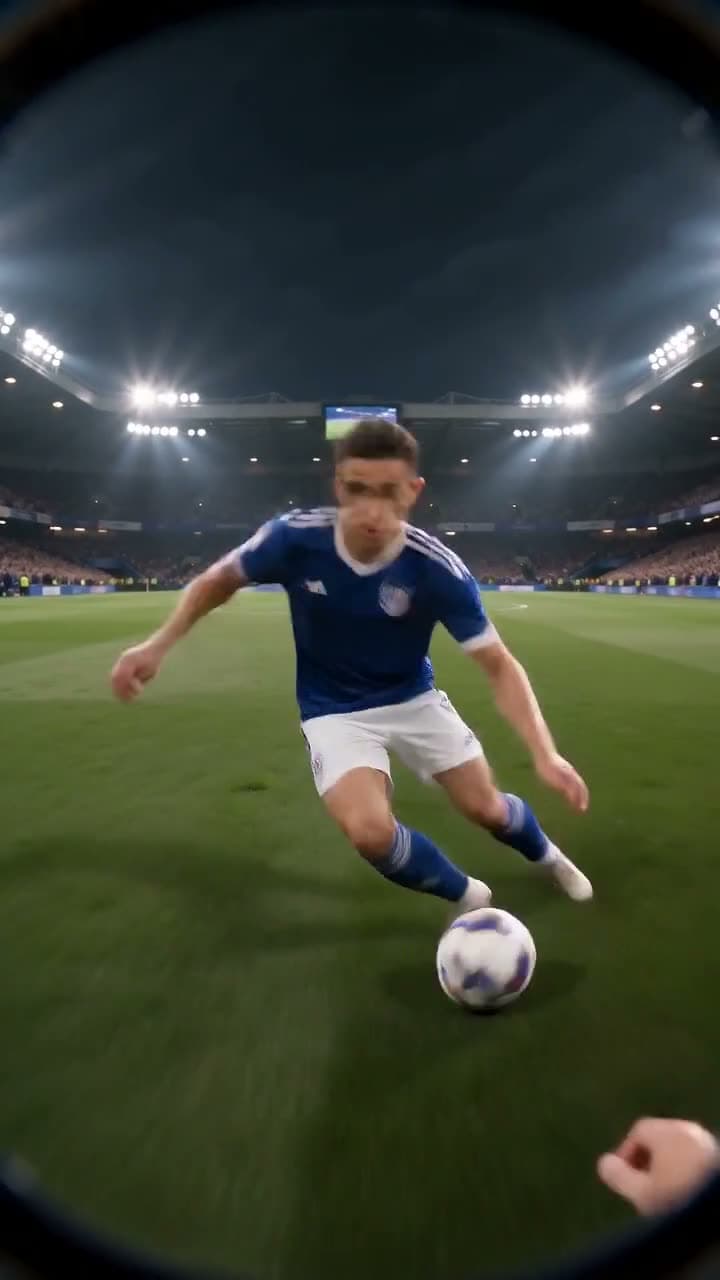
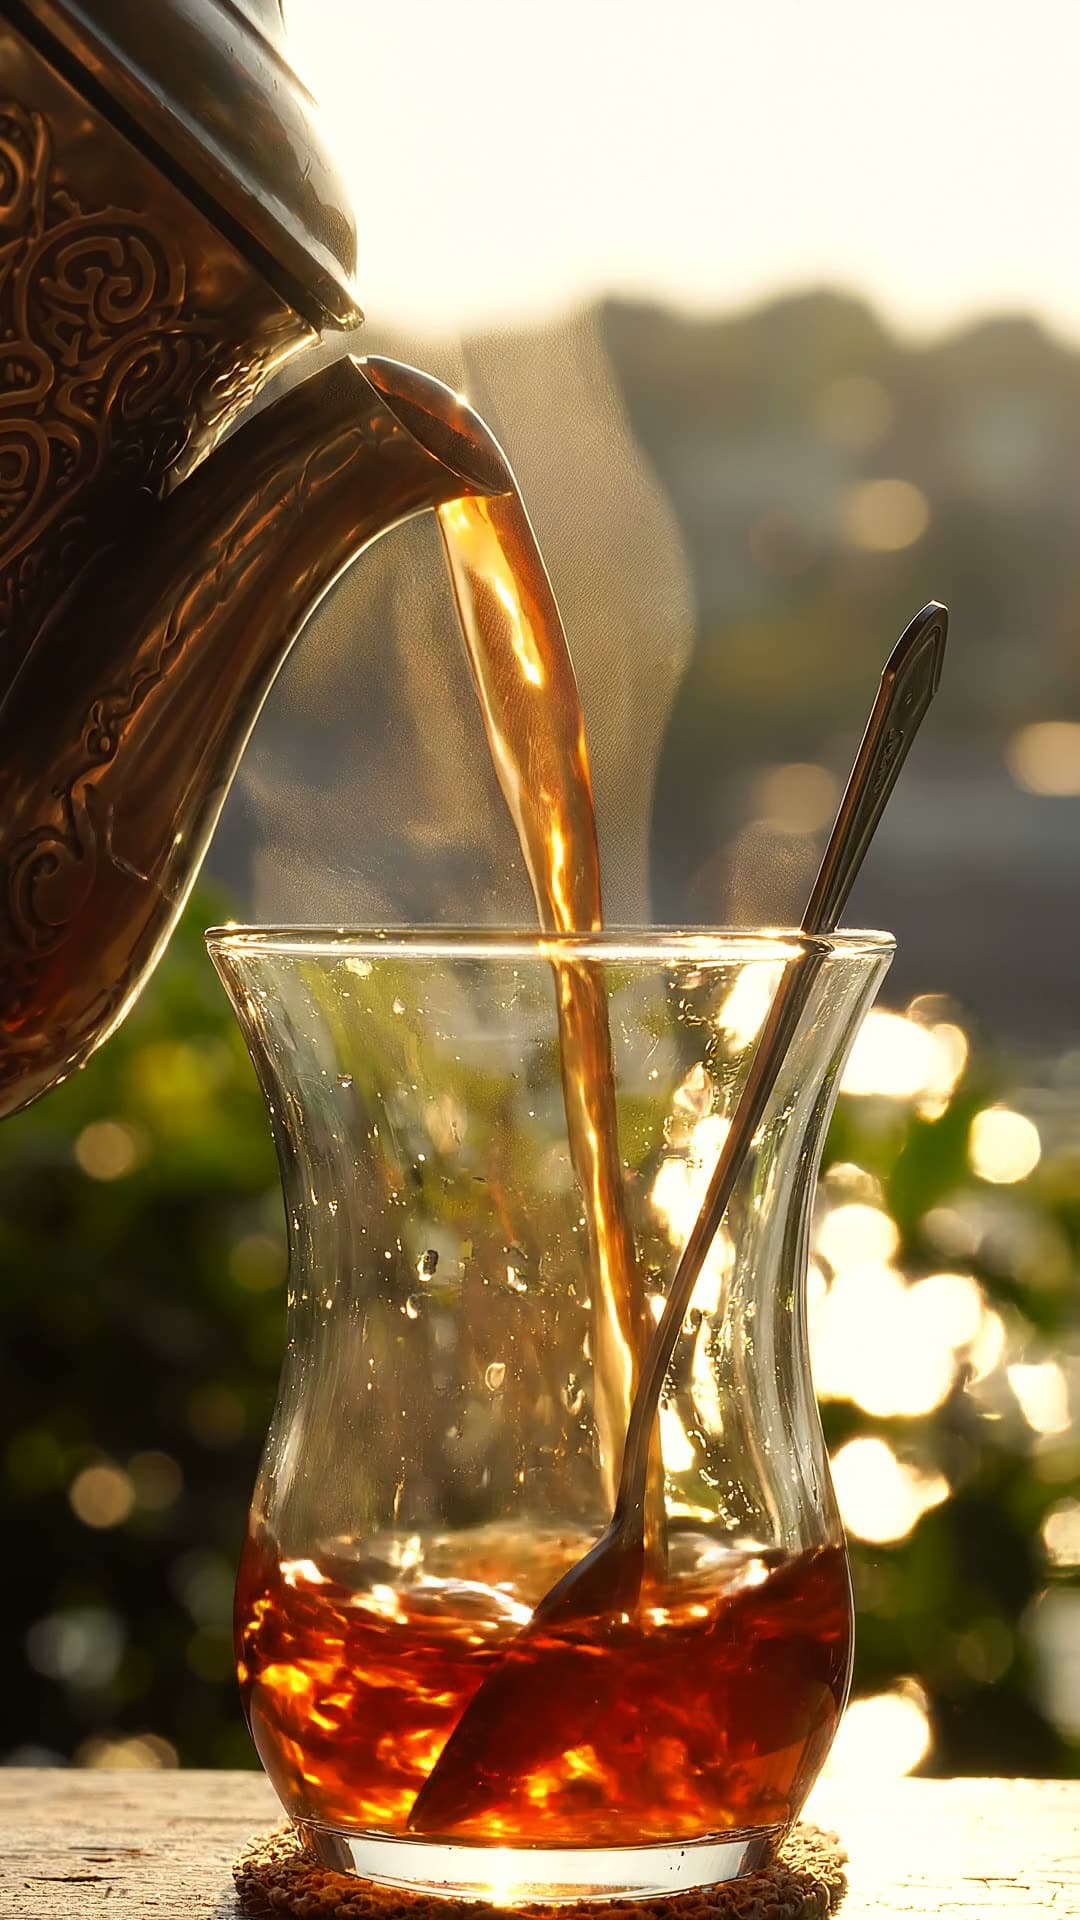
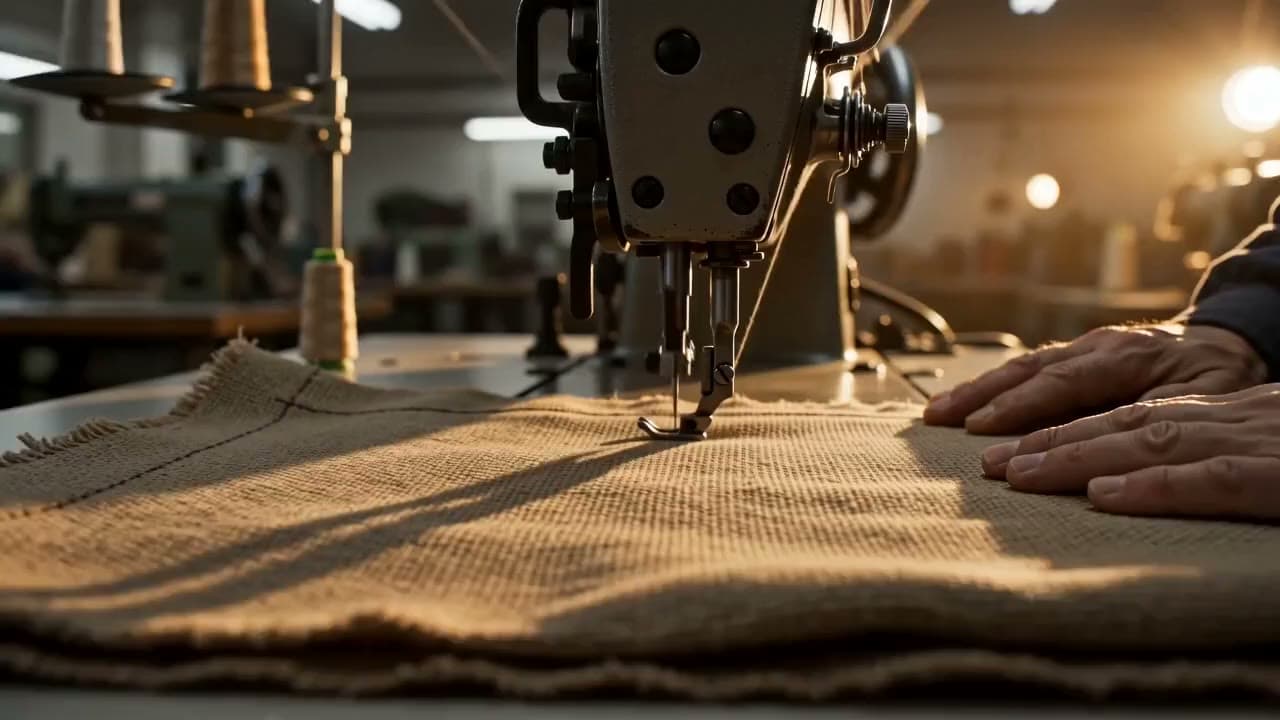
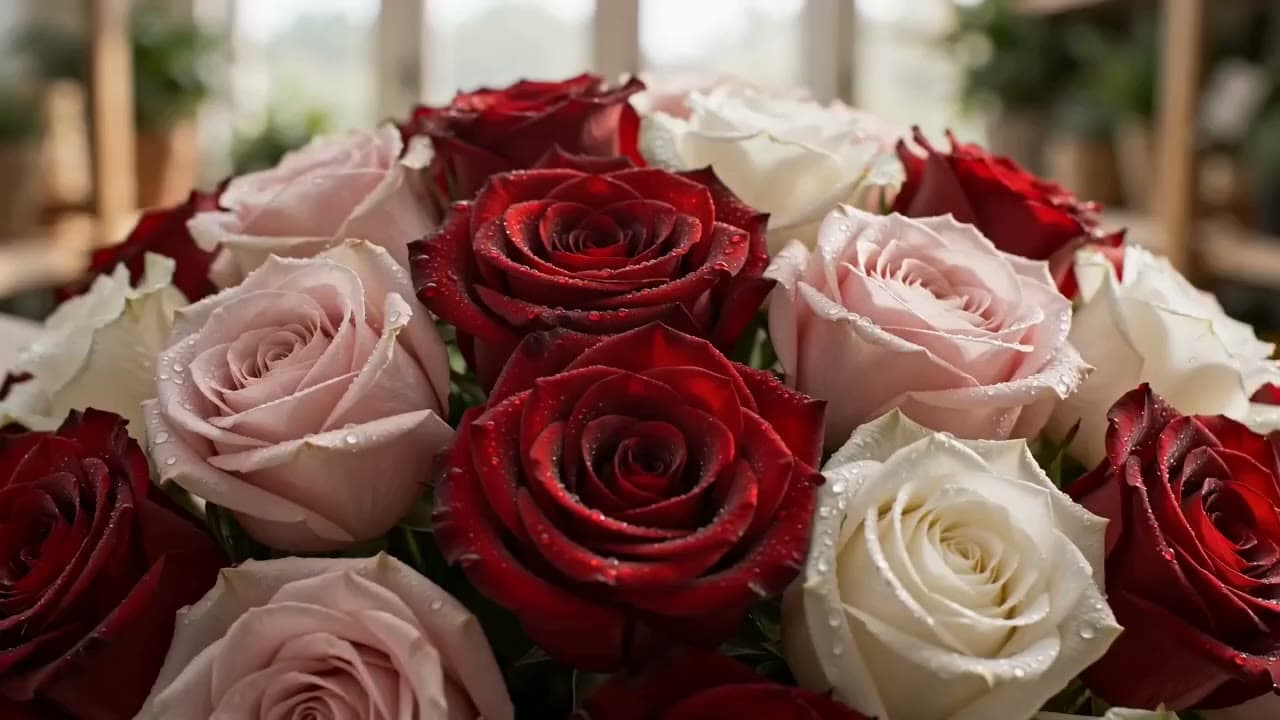
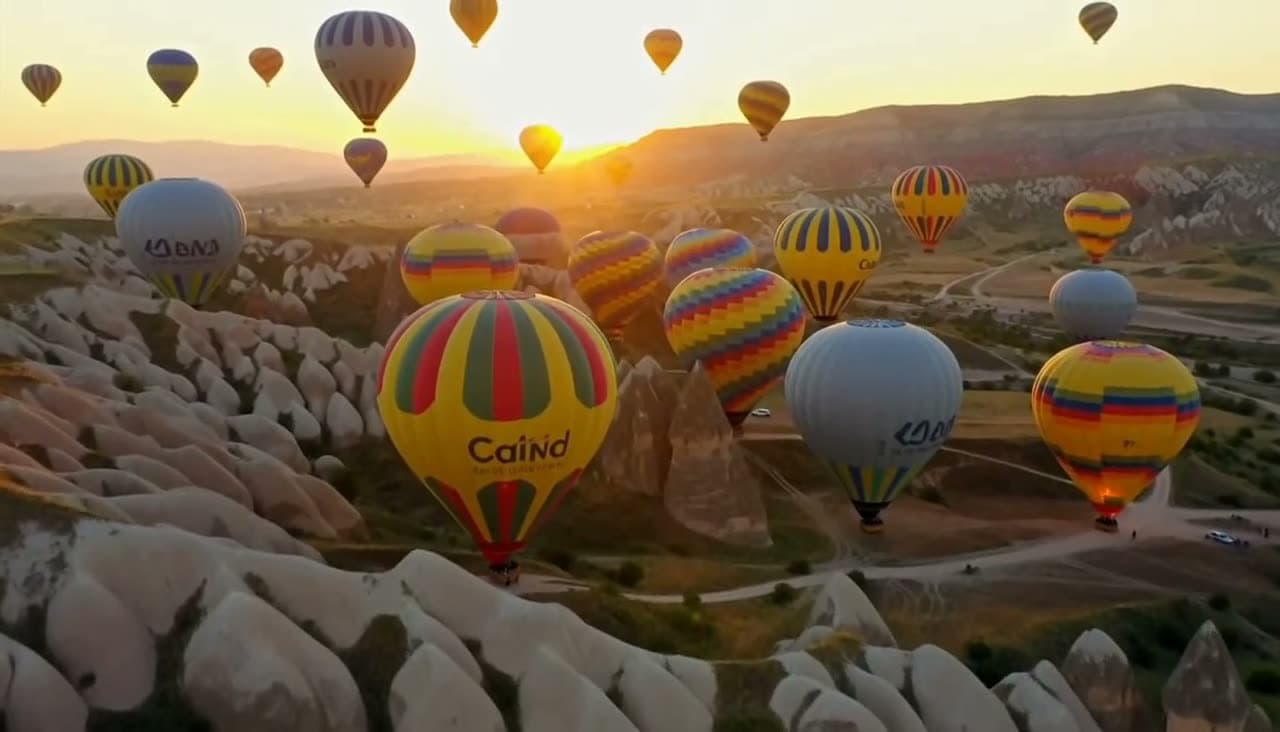
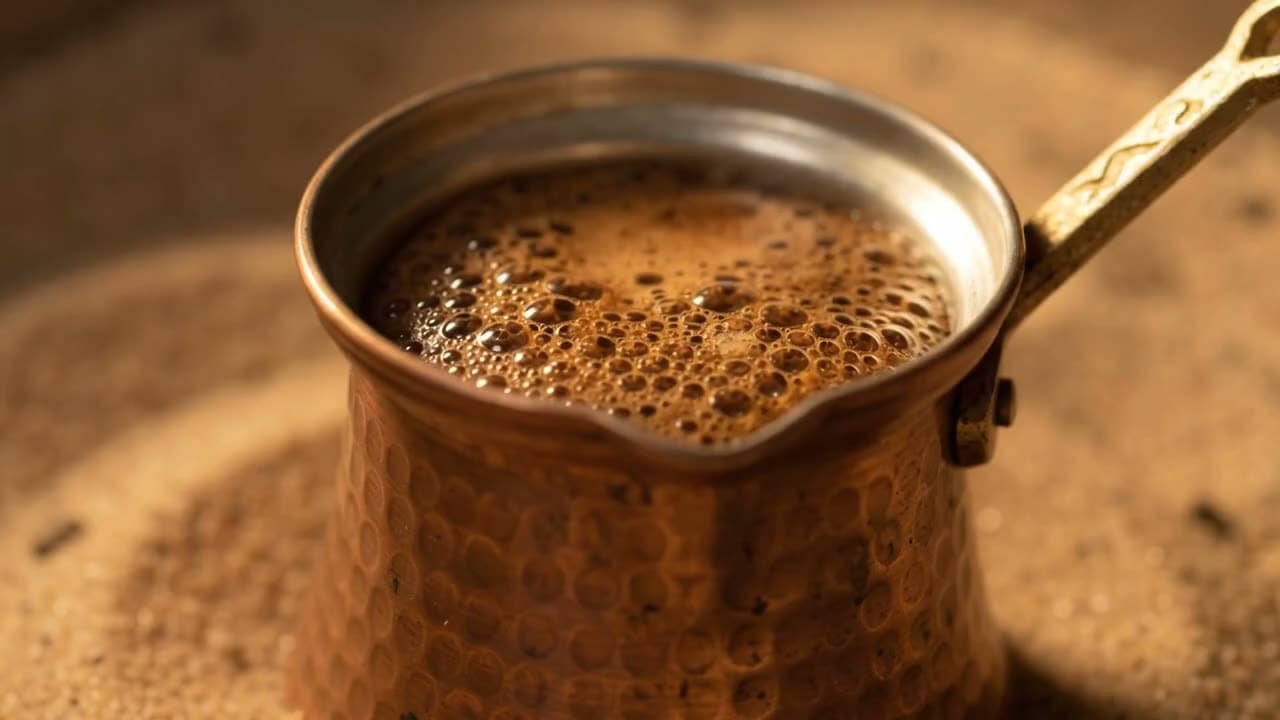
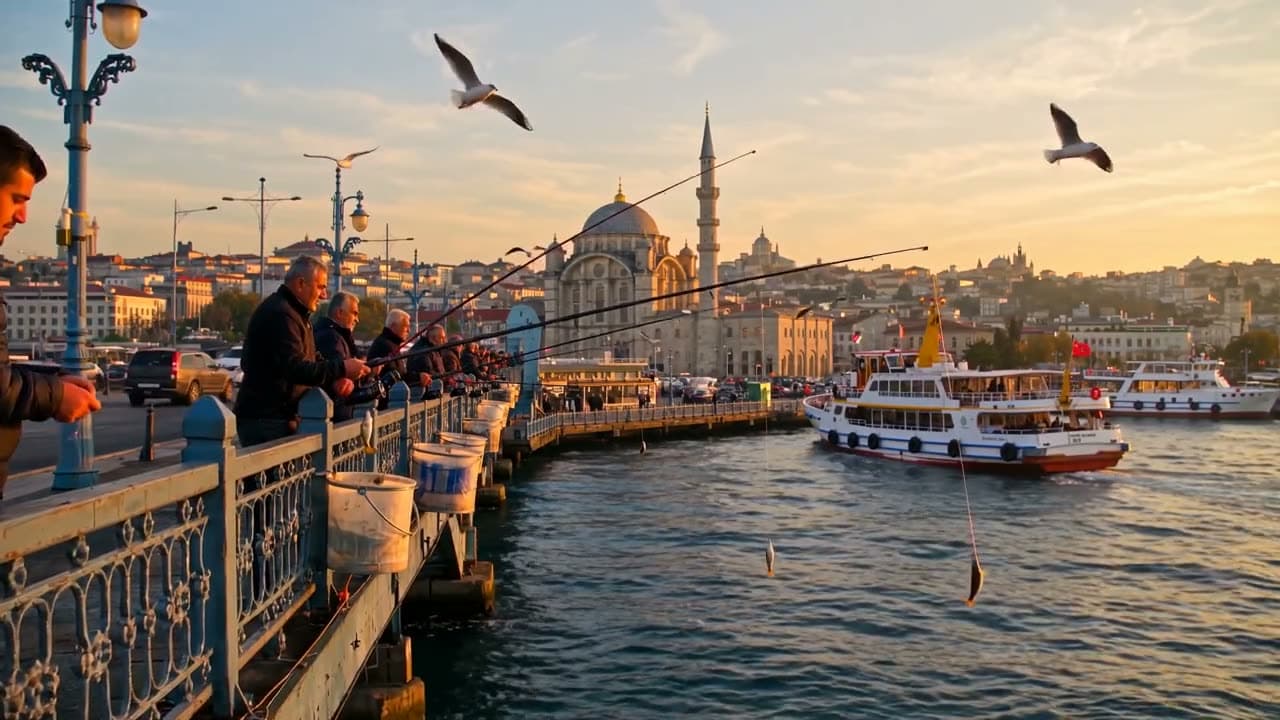
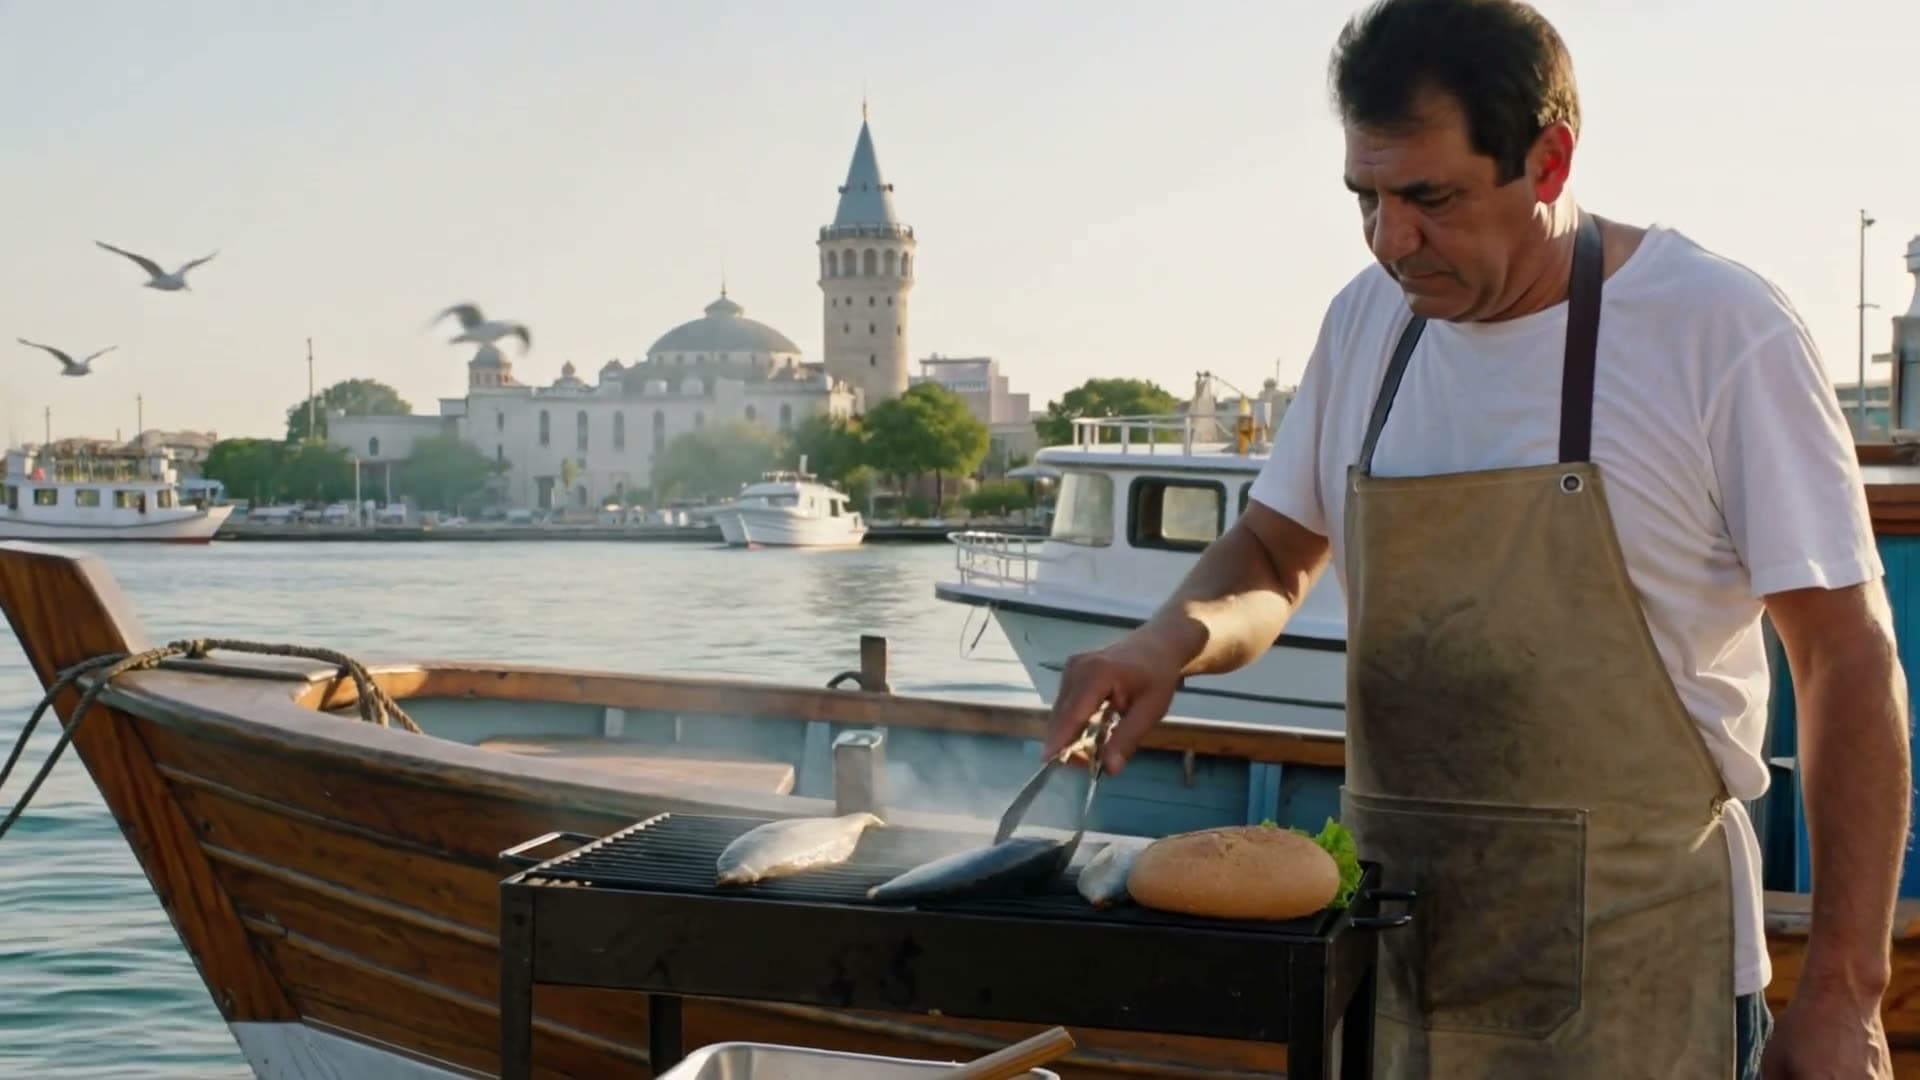
Cómo funciona
Tres pasos
Describe la escena
Di quién aparece, dónde ocurre y qué hace. Agrega movimiento de cámara, luz o clima si te importan.
Elige modelo, duración y formato
Los clips duran de 3 a 30 segundos según el modelo. Vertical para TikTok, Reels y Shorts; horizontal para YouTube.
Genera y descarga
La generación corre en segundo plano, así que puedes cerrar la pestaña. El video terminado te espera en tu Biblioteca como MP4.
Modelos
Modelos que puedes usar
Los precios están en créditos y ves el costo exacto antes de generar. Los paquetes de créditos empiezan en 5 US$ por 75 créditos.
Seedance 2.5
ByteDance
Una sola toma de hasta 30 segundos, o hasta 25 segundos en Full HD. El modelo más ambicioso del catálogo, y el más caro.
Seedance 2.0
ByteDance
El Seedance más accesible: video con sonido de hasta 15 segundos, hasta 4K, a un precio equilibrado.
Seedance 2.0 Mini
ByteDance
El Seedance más económico: clips cortos y rápidos con sonido para redes sociales.
MiniMax H3 Max Turbo
MiniMax
Rápido y económico, suficiente para redes sociales. También genera sonido.
MiniMax H3 Max
MiniMax
Un salto claro en movimiento y detalle. Está entre los primeros en pruebas independientes de video con sonido.
Google Gemini Omni Flash
Los resultados más realistas, con sonido sincronizado. Pensado para anuncios y videos promocionales.
Google Veo 3.1 Lite
La versión más accesible del modelo de video de Google. Genera diálogo y sonido ambiente junto con la imagen.
Wan 3.0
Alibaba
Una sola toma de hasta 30 segundos, en Full HD. Ideal para escenas más largas.
Kling 4.0
Kuaishou
El modelo más nuevo de Kling: una sola toma de hasta 30 segundos, siempre con sonido estéreo. 720p o Full HD, incluido el formato cinematográfico 21:9.
Kling 3.0
Kuaishou
La generación anterior de Kling: hasta 15 segundos, con o sin sonido. Standard es 720p y Pro es 1080p. La voz integrada es en inglés o chino.
Destacados
Por qué crearlo aquí
Con sonido incluido
Todos los modelos de aquí generan sonido ambiente junto con la imagen. En Seedance 2.5, Seedance 2.0, Seedance 2.0 Mini, Google Veo 3.1 Lite, Wan 3.0 y Kling 3.0 puedes desactivar el audio.
Los mejores modelos, un solo saldo
Modelos de Google, ByteDance, Alibaba y MiniMax lado a lado. Prueba el mismo prompt en varios sin pagar suscripciones por separado.
Hasta 30 segundos
Seedance 2.5, Wan 3.0 y Kling 4.0 generan hasta 30 segundos en una sola toma, sin cortes que unir.
Ayuda con el prompt
A los prompts cortos les agregamos detalles de cámara, luz y movimiento. Desactívalo cuando quieras y envía tus propias palabras.
Créditos de vuelta si falla
Si una generación no termina, te devolvemos los créditos automáticamente. Sin abrir un ticket de soporte.
Listo para redes
Formatos vertical, cuadrado y horizontal (según el modelo) que encajan en TikTok, Instagram y YouTube sin recortar.
Comparativa
Qué te da cada modelo de texto a video
La duración, la resolución, la relación de aspecto y el sonido dependen del modelo. La tabla sale directo de nuestro catálogo de modelos, así que coincide con lo que ves en el estudio.
| Modelo | Duración | Resolución | Formato | Sonido |
|---|---|---|---|---|
| Seedance 2.5ByteDance | 4, 5, 6, 8, 10, 12, 15, 20, 25, 30 seg | 480p / 720p / 1080p | 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Sí, se puede desactivar |
| Seedance 2.0ByteDance | 4, 5, 6, 8, 10, 12, 15 seg | 480p / 720p / 1080p / 4K | 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Sí, se puede desactivar |
| Seedance 2.0 MiniByteDance | 4, 5, 6, 8, 10, 12, 15 seg | 480p / 720p | 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Sí, se puede desactivar |
| MiniMax H3 Max TurboMiniMax | 5, 10, 15 seg | 480p / 768p / 1080p | 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Sí |
| MiniMax H3 MaxMiniMax | 5, 10, 15 seg | 480p / 768p / 1080p | 16:9, 9:16, 1:1, 4:3, 3:4, 21:9 | Sí |
| Google Gemini Omni FlashGoogle | 5, 8, 10 seg | 360p / 720p / 1080p / 4K | 16:9, 9:16 | Sí |
| Google Veo 3.1 LiteGoogle | 4, 6, 8 seg | 720p / 1080p | 16:9, 9:16 | Sí, se puede desactivar |
| Wan 3.0Alibaba | 5, 10, 15, 20, 30 seg | 480p / 720p / 1080p | 16:9, 9:16, 1:1, 4:3, 3:4 | Sí, se puede desactivar |
| Kling 4.0Kuaishou | 3, 5, 8, 10, 15, 20, 25, 30 seg | 720p / 1080p | 16:9, 9:16, 1:1, 21:9 | Sí |
| Kling 3.0Kuaishou | 3, 5, 8, 10, 15 seg | 720p / 1080p | 16:9, 9:16, 1:1 | Sí, se puede desactivar |
En resumen: para probar una idea gastando poco, empieza con MiniMax H3 Max Turbo (13 créditos por 5 segundos en 480p). Para una sola toma de hasta 30 segundos, usa Seedance 2.5, Wan 3.0 o Kling 4.0. Si buscas el resultado más realista y una opción en 4K, elige Google Gemini Omni Flash. Veo 3.1 Lite queda en medio y es el indicado cuando quieres que alguien diga una frase corta en el clip.
Prompts
Cómo escribir un prompt de texto a video
Los buenos prompts suelen responder las mismas preguntas en el mismo orden: quién o qué aparece, qué hace, dónde ocurre, cómo se mueve la cámara, cómo es la luz y qué se escucha. Este ejemplo cubre las seis:
Un golden retriever con impermeable amarillo salta sobre los charcos de una acera de la ciudad al atardecer. Toma baja de seguimiento detrás del perro, las luces cálidas de la calle se reflejan en el pavimento mojado. Sonido de lluvia y tráfico a lo lejos.
- Una sola acción por clip. Pedir que pasen tres cosas en 5 segundos suele dejar las tres a medias.
- Nombra el movimiento de cámara: acercamiento lento, cámara en mano, toma con dron, toma baja de seguimiento. Los modelos los respetan bien.
- Describe el sonido que quieres, como lluvia, el murmullo de la gente o una cafetera silbando. Si no, el modelo decide.
- No pidas texto en pantalla. Las letras salen deformadas; mejor agrega los subtítulos en tu editor.
- En video vertical, deja al protagonista en el centro del cuadro para que no se corte nada importante.
Los prompts cortos también funcionan. Antes de enviarlos al modelo les agregamos detalles de cámara, luz y movimiento; puedes desactivarlo en la configuración avanzada y mandar tu texto tal como lo escribiste.
Cuál elegir
¿Texto a video o imagen a video?
Usa texto a video cuando no tienes una imagen o quieres construir la escena desde cero. Si tiene que aparecer un producto, un lugar o una persona concretos, imagen a video da resultados más consistentes, porque tu foto se convierte en el primer cuadro.
Si la toma necesita un logo o un texto legible, crea el primer cuadro con el generador de imágenes IA y después anímalo. Los modelos de imagen escriben letras mucho mejor que los de video.
Para que alguien diga una frase exacta a cámara, usa Foto que habla. Primero pone voz a tu texto y luego sincroniza los labios de un retrato con ella, algo mucho más fiable que pedirle a un modelo de video que hable.
Preguntas frecuentes
Dudas comunes
¿Cómo funciona la IA de texto a video?
Escribes la descripción de una escena. Un modelo de video entrenado con enormes cantidades de material filmado convierte esa descripción en cuadros nuevos y, en los modelos de aquí, también en un sonido acorde. No busca clips que ya existan: cada video se genera desde cero.
¿Hay una IA de texto a video gratis?
Aquí no. Le pagamos al proveedor de IA por cada video e imagen que generamos, y las pruebas gratis dispararon ese costo. Antes de comprar, puedes ver en nuestra página de ejemplos resultados sin editar que creamos con estos mismos modelos. Las cuentas nuevas reciben 20 créditos de regalo al verificar su correo, y sirven para voz en off; las herramientas de video se activan con tu primera compra de créditos. Un clip de 5 segundos en MiniMax H3 Max Turbo cuesta 13 créditos en 480p y 20 en 768p, y la opción más pequeña es el paquete Mini, con 75 créditos por 5 US$. No hace falta suscripción y los créditos no vencen.
¿Cuánto cuesta un clip de texto a video?
Depende del modelo, la duración y la resolución. Con los precios de hoy, MiniMax H3 Max Turbo cuesta 13 créditos por 5 segundos en 480p (0,47 US$–0,87 US$), Veo 3.1 Lite 40 créditos por 8 segundos (1,45 US$–2,67 US$), Wan 3.0 100 créditos por 10 segundos y Seedance 2.5 147 créditos por 5 segundos. El monto en dinero depende del paquete de créditos que compres. El costo exacto aparece en el botón de generar antes de que gastes nada.
¿Qué modelos de video con IA puedo usar?
Seedance 2.5, Seedance 2.0, Seedance 2.0 Mini, MiniMax H3 Max Turbo, MiniMax H3 Max, Google Gemini Omni Flash, Google Veo 3.1 Lite, Wan 3.0, Kling 4.0 y Kling 3.0. Todos generan sonido con el video. La duración, la resolución y el precio cambian según el modelo.
¿Cuánto puede durar un clip de texto a video?
Entre 3 y 30 segundos por generación. Seedance 2.5, Wan 3.0 y Kling 4.0 llegan hasta 30 segundos; en Seedance 2.5, la resolución 1080p permite hasta 25 segundos. Para algo más largo, genera varios clips y edítalos juntos.
¿El video puede incluir diálogo?
Los modelos de video son buenos con el sonido ambiente y pueden con una frase corta, pero las palabras y el movimiento de los labios no son confiables. Cuando importa lo que se dice exactamente, usa Foto que habla: primero se graba la voz de tu guion y luego se sincronizan los labios de un retrato con ella.
¿Cuánto tarda?
Normalmente de uno a cinco minutos, según el modelo y la duración. La generación sigue aunque cierres la pestaña, y el video aparece en tu Biblioteca cuando termina.
¿Puedo usar los videos con fines comerciales?
Sí, puedes usar lo que generes para tu propio negocio y en anuncios, siempre que respetes nuestros términos. Tú eres responsable de tener los derechos de todo lo que subas y de no mostrar a personas reales sin su permiso.
¿Tengo que instalar algo?
No. Todo funciona en el navegador, en computadora o celular, y la generación ocurre en los servidores del proveedor del modelo. Descargas el resultado como MP4.
¿Qué hace bueno a un prompt de texto a video?
Cubre el protagonista, la acción, el lugar, el movimiento de cámara, la luz y el sonido, en ese orden. Una acción por clip y nada de texto en pantalla. Un prompt claro de dos frases funciona mejor que una larga lista de adjetivos.
- Cada generación dura como máximo 30 segundos. Para un video más largo, genera varios clips y únelos en un editor.
- El texto dentro del video, como letreros, logos o subtítulos, suele salir deformado. Mejor crea el primer cuadro con el generador de imágenes y anímalo.
- No se pueden generar personas reales, celebridades ni personajes con derechos de autor. Los filtros de seguridad de los modelos rechazan esos prompts.
- El mismo prompt da un video distinto cada vez. No es posible reproducir un clip exactamente igual.
- Los diálogos no siempre salen bien. Si una persona tiene que decir una frase concreta, Foto que habla sincroniza los labios con una voz en off y es mucho más fiable.
Páginas relacionadas
- Imagen a videoEmpieza con tu propia foto para resultados más consistentes.
- Generador de imágenes IACrea un primer cuadro con texto legible o un logo.
- Foto que hablaUn retrato que dice tu guion con los labios sincronizados.
- Voz en off con IANarración para tus clips en MP3.
- Efectos de video con IAPlantillas con una foto, como abrazo y baile.
- PreciosPaquetes de créditos y planes.
Pruébalo ahora
Registrarte es gratis. Esta herramienta se activa con tu primera compra de créditos, y los paquetes empiezan en 5 US$ por 75 créditos. No necesitas suscripción, y puedes ver los ejemplos de arriba antes de decidir.
Crear un video desde texto